Portal Expensas
Introducción
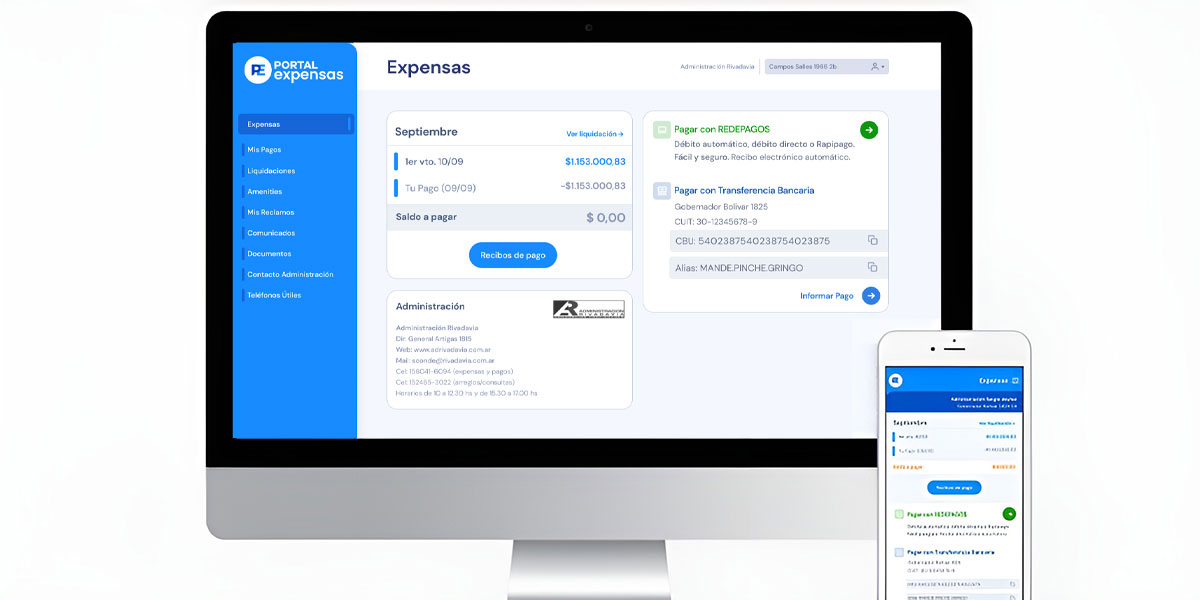
Portal Expensas es una plataforma digital (web y mobile) para la gestión de consorcios y la administración de expensas en edificios. La solución fue desarrollada para modernizar un sistema con más de 20 años de trayectoria en el sector PropTech, utilizado por administradores que hoy gestionan más de 200.000 unidades funcionales.
Con el paso del tiempo, el software original fue acumulando funcionalidades valiosas, pero también una fuerte deuda técnica que limitaba la evolución del negocio. Desde 404 Crafters acompañamos su transformación digital. En este proyecto lideré el equipo técnico, diseñé la arquitectura general y desarrollé varios de los componentes clave. Diseñamos y desarrollamos una nueva experiencia para propietarios e inquilinos, centrada en la simplicidad, la autonomía y la comunicación efectiva con la administración.
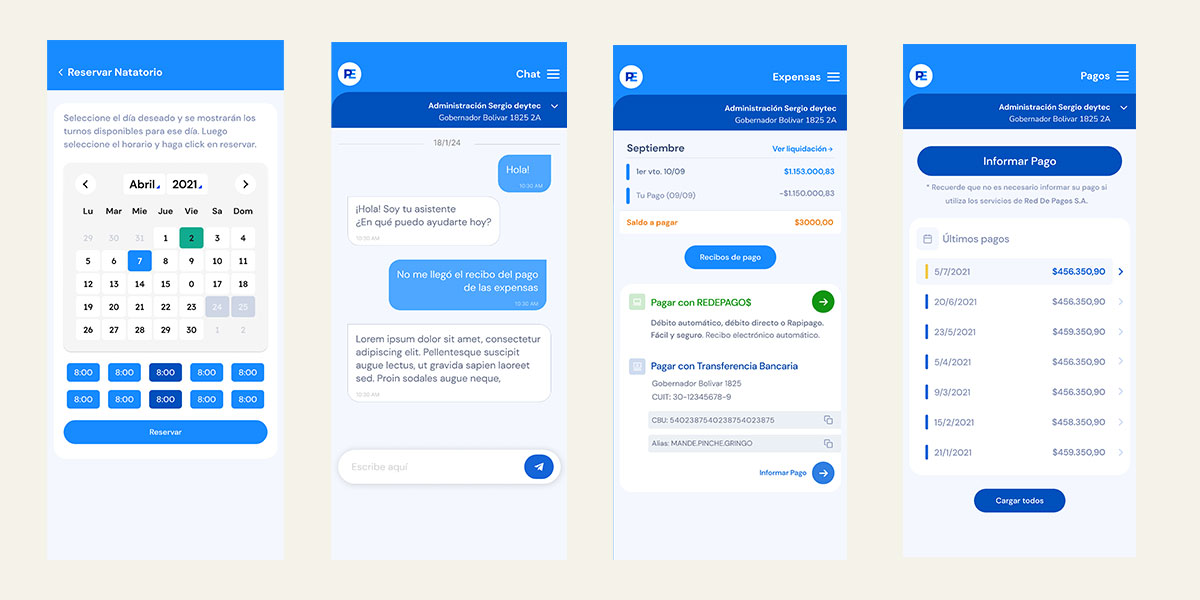
El nuevo sistema permite a propietarios e inquilinos consultar el estado de cuenta, realizar pagos, descargar recibos, acceder a documentos y liquidaciones anteriores, hacer reclamos, reservar amenities, participar en encuestas y recibir comunicaciones importantes desde la administración.
Además, desarrollé una API de integración que conecta esta nueva capa con el sistema core heredado, permitiendo una evolución progresiva sin frenar el negocio y habilitando nuevos servicios para el ecosistema del consorcio.
Actualmente, más de 50.000 usuarios utilizan la app cada mes, y el número continúa creciendo.
Enfoque técnico
Portal Expensas está compuesto por una aplicación mobile (Android e iOS) desarrollada en React Native, una aplicación web construida con React y una API desarrollada en Kotlin sobre la JVM.
Elegí Kotlin como lenguaje principal del backend por su expresividad, productividad y equilibrio entre el paradigma orientado a objetos y funcional. Permite escribir código claro y declarativo, sin la verbosidad de Java.
Librerías por sobre frameworks
Evito utilizar frameworks, puesto que introducen mucha indirección, complejidad innecesaria y hacen perder el control de la aplicación (es el framework quien la controla). En su lugar, prefiero librerías livianas y un diseño simple, explícito y sostenible.
Para la capa web de la API utilicé Javalin, una librería minimalista que envuelve a Jetty, ideal para mantener bajo control el flujo de requests sin magia.
Persistencia
Para la persistencia, descarté el uso de ORMs: introducen sobreingeniería, esconden el SQL y promueven un modelo inadecuado para dominios ricos. En su lugar usamos jOOQ, un DSL de SQL tipado que permite mantener control total sobre las consultas, integrándolo con el patrón Repository para encapsular el acceso a datos de forma clara y mantenible. Los ORMs suelen mapear tablas a estructuras de datos, no a objetos ricos de dominio. Prefiero separar explícitamente las capas y modelar el dominio con intención.
Utilizamos PostgreSQL como base de datos y Flyway para el versionado.
Inyección de dependencias explícita
No utilizo contenedores de inyección de dependencias. Con una arquitectura clara, la inyección manual de dependencias es sencilla y minimiza la indirección. Esto mejora la legibilidad del sistema y el seguimiento de los flujos de ejecución.
Herramientas auxiliares
Desarrollé una herramienta CLI en JavaScript: una consola de desarrollo que automatiza tareas frecuentes y nos ayuda a mejorar la productividad. Además, creé PopulateDB, una utilidad que permite inicializar la base de datos de desarrollo con distintos escenarios y contextos, facilitando el desarrollo y la validación de funcionalidades en distintos casos de uso.
CI/CD y despliegue
Utilizamos AWS como plataforma cloud, con ECS para orquestación de contenedores, ECR para imágenes Docker y RDS como base de datos. Automatizamos el aprovisionamiento completo de los entornos de staging y producción con Terraform, incluyendo configuración de servicios, redes (VPC), reglas de firewall y dependencias.
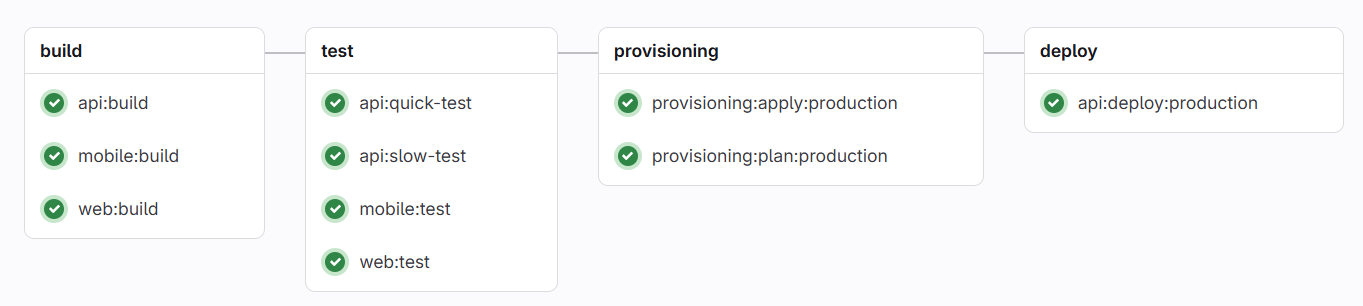
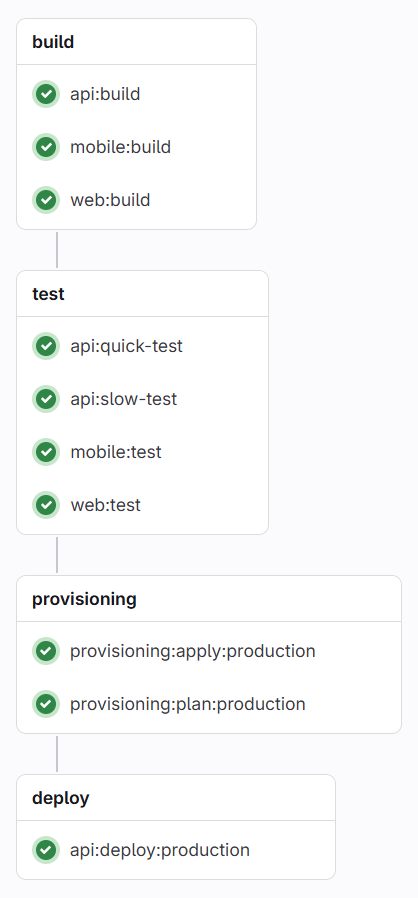
El pipeline de CI/CD fue implementado en GitLab CI e incluye:
- Ejecución automática de tests unitarios, de integración y end-to-end
- Construcción de imágenes Docker versionadas y subida a ECR
- Despliegue automatizado en ECS
- Ejecución de migraciones con Flyway cuando corresponde
- Provisioning completo de staging en cada cambio de infraestructura
- Paso de aprobación manual para producción, con visualización del diff de Terraform antes de aplicar los cambios
Además, diseñé un sistema de feature flags centralizado que permite activar o desactivar funcionalidades en tiempo real, tanto desde el backend como desde las aplicaciones mobile y web. Esto nos permitió separar el deploy del release, reduciendo el riesgo y habilitando rollouts graduales.
Monorepo
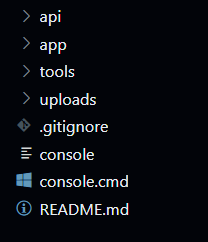
Utilizamos un monorepo para agrupar todos los componentes del sistema: backend, frontend web, mobile y herramientas internas. Esto simplificó enormemente el setup local (que se hace con un solo comando), favoreció el versionado sincronizado de cambios y facilitó el desarrollo full-stack. Gracias a la arquitectura del frontend —que describo más adelante—, logramos reutilizar alrededor del 80% del código entre las versiones web y mobile, lo que nos permitió reducir duplicación, acelerar el desarrollo y mantener consistencia funcional entre plataformas.
Arquitectura
Decidí aplicar Domain-Driven Design y organizar el sistema siguiendo los principios de Clean Architecture. Sus beneficios son múltiples:
- Separación clara de responsabilidades
- Independencia de decisiones tecnológicas (permitiendo que el proyecto sobreviva mejor al paso del tiempo)
- Gestión de dirección de dependencias desde los detalles de bajo nivel a los conceptos de alto nivel
- Facilidad de testing y evolución
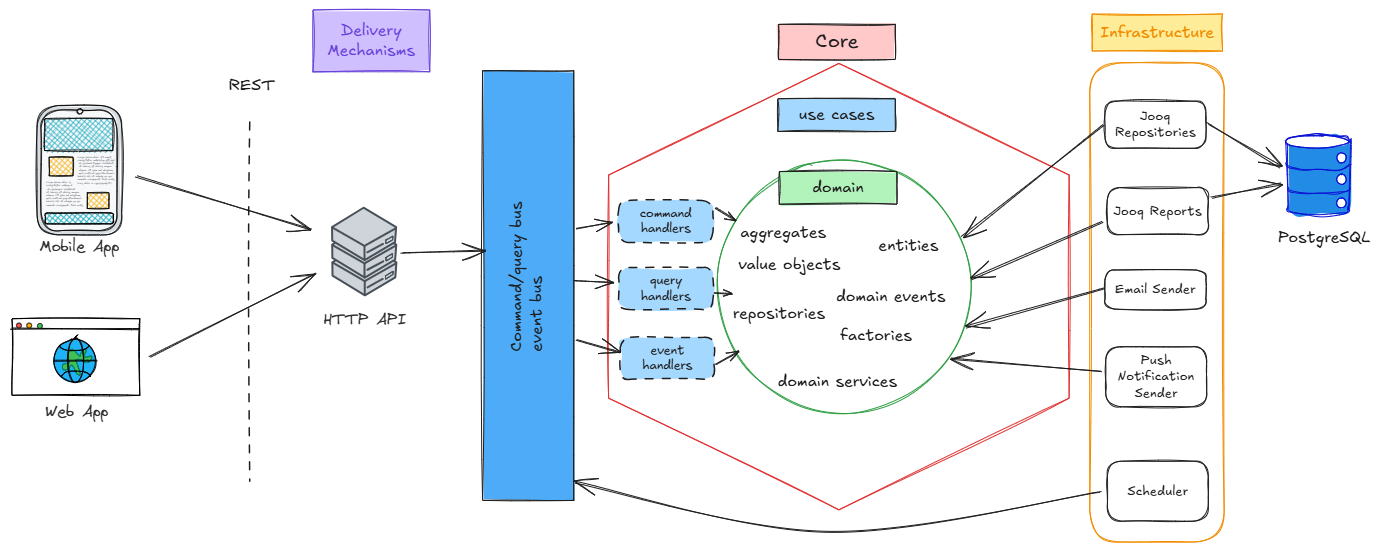
Tanto las aplicaciones mobile como web se comunican con la API REST, que funciona como mecanismo de delivery.
- La capa web de la API contiene controllers livianos que interpretan los requests y los traducen a comandos o queries.
- Estos comandos/queries se enrutan mediante un bus que invoca al handler correspondiente (caso de uso).
- Los casos de uso coordinan la ejecución de la lógica necesaria del dominio.
- El dominio contiene el corazón del sistema: modelos ricos, reglas de negocio, servicios de dominio y generación de eventos.
La responsabilidad de los casos de uso es implementar la lógica de aplicación (no de negocio). Son coordinadores: activan las funcionalidades de dominio necesarias.
El dominio modela el negocio y su lógica. Se usa el principio de inversión de dependencias para implementar aquellos servicios que requieren algún aspecto tecnológico (persistencia, notificaciones, servicios externos). Las implementaciones de estas tecnologías están en la capa de infraestructura. Como las dependencias están invertidas (la infraestructura depende del dominio y no al revés), es muy sencillo cambiar decisiones tecnológicas: se modifica la configuración de la aplicación indicando qué tecnología se quiere utilizar.
Arquitectura frontend
En el frontend, la lógica de negocio es limitada, pero la velocidad de cambio tecnológico es alta. Por eso adopté una versión más liviana de Clean Architecture. Los beneficios son similares a los de backend, pero en frontend tienen un impacto aún mayor por la velocidad de cambio tecnológico y la fragilidad de los tests de UI.
Este diseño me permitió aplicar TDD de forma efectiva, reducir el acoplamiento y mantener la agilidad del equipo frente a cambios.
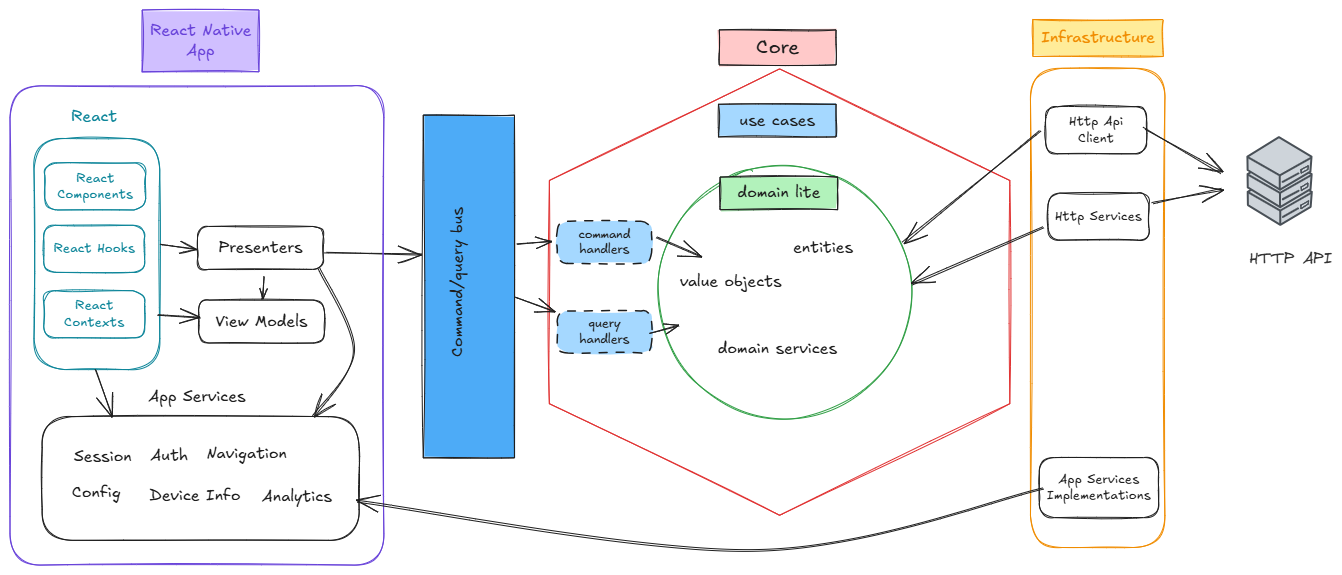
Uso React no como framework sino como librería de UI. Casi no uso hooks, ni librerías de manejo de estado. La lógica de vista se encapsula en Presenters: clases de TypeScript puras, sin ninguna dependencia de React. Los Presenters invocan casos de uso para activar lógica de negocio (que puede ser local o remota en la API), formatean los datos y exponen ViewModels con la información ya lista para mostrar.
Esta estructura permite reemplazar React por otra tecnología o versión sin reescribir la lógica, facilita el testing y desacopla la app del framework. Cambiar React por Vue, por ejemplo, sería reemplazar la capa de React. No habría que modificar ningún Presenter, ViewModel ni App Service.
Esto permite que la aplicación sobreviva al paso del tiempo pudiendo adaptarse a las nuevas tecnologías rápidamente.
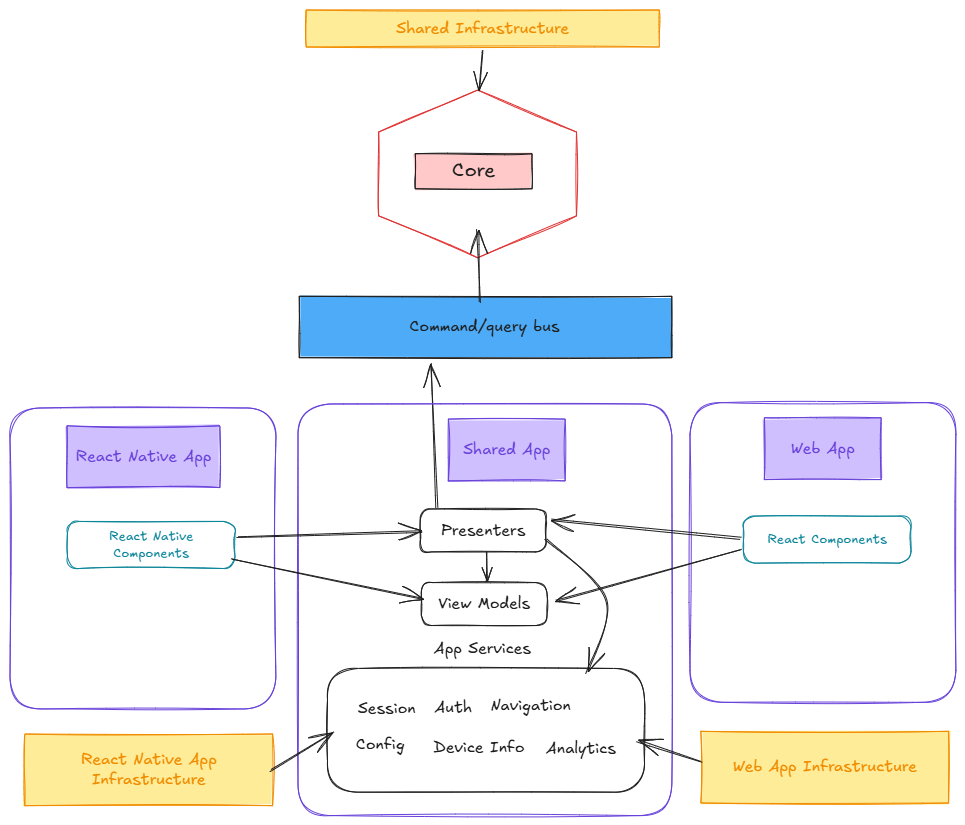
En Portal Expensas, aprovechamos esta arquitectura para compartir alrededor del 80% del código entre las versiones mobile y web. Todo el core de la aplicación, los App Services y Presenters se reutilizaron entre ambas plataformas, lo que nos permitió mantener una única fuente de verdad para la mayor parte del comportamiento.
El esquema es lo suficientemente flexible como para permitir presenters específicos cuando ciertas pantallas requieren diferencias significativas entre plataformas. Esta estrategia nos trajo beneficios concretos: aumentó la productividad, redujo la duplicación de código y facilitó el mantenimiento y la evolución del sistema en paralelo.
Modelado de dominio
Portal Expensas cuenta con un modelo de dominio rico y expresivo.
- Identidades modeladas como value objects: cada entidad tiene su identificador representado explícitamente como un value object, reforzando la noción de identidad persistente a lo largo del tiempo, incluso frente a cambios en sus atributos.
- Eventos de dominio: utilicé eventos de dominio para desacoplar los casos de uso y representar de forma explícita ciertas políticas de negocio. Esto permitió mayor claridad en los flujos y mejor extensibilidad ante futuros escenarios.
- CQRS simplificado: implementé una versión simple de CQRS. En la capa de aplicación, los queries más simples acceden directamente al dominio usando repositorios. En cambio, para queries más complejos, se accede directamente a la base de datos mediante jOOQ, consultando vistas construidas sobre las tablas del modelo de escritura. Para estos casos, modelamos modelos de lectura específicos, diseñados para exponer exactamente los datos que cada query necesita, sin forzar una carga innecesaria del modelo de dominio.
Ejemplo de Value Object:
class Address(
    val street: String,
    val city: String,
    val countryCode: CountryCode,
    val zipCode: String? = null,
) {
    init {
        street.ifBlank { throw RequiredArgumentError("street") }
        city.ifBlank { throw RequiredArgumentError("city") }
        zipCode?.ifBlank { throw ArgumentCannotBeEmptyError("zipCode") }
    }

    override fun equals(other: Any?) =
        other is Address &&
        other.street == street &&
        other.city == city &&
        other.countryCode == countryCode &&
        other.zipCode == zipCode

    override fun hashCode(): Int {
        var result = street.hashCode()
        result = 31 * result + city.hashCode()
        result = 31 * result + countryCode.hashCode()
        result = 31 * result + (zipCode?.hashCode() ?: 0)
        return result
    }

    override fun toString(): String {
        return "Address($street, $city, $countryCode, $zipCode)"
    }
}
Ejemplo de un caso de uso de tipo evento:
class OnNewAmenityCreateAmenityBookingConfig(private val amenityBookingConfigs: AmenityBookingConfigs): EventHandler {
    override val eventTypes = listOf(AmenityCreated::class)

    override fun onEvent(event: Event) {
        if (event is AmenityCreated) { onAmenityCreated(event) }
    }

    private fun onAmenityCreated(event: AmenityCreated) {
        val bookingConfig = AmenityBookingConfig.createDefaultFor(event.amenity)
        amenityBookingConfigs.add(bookingConfig)
    }
}
Ejemplo de un caso de uso:
@RequiredFeatures([CLAIMS])
@Authorization([Admin])
data class CloseClaim(val claimId: Id<Claim>): PureCommand {

    internal class Handler(private val repositories: RepositoryProvider): RequestHandler<CloseClaim, Unit> {
        override fun execute(request: CloseClaim, identity: Identity) {
            val claim = repositories.claims().get(request.claimId)
            claim.close()
            repositories.claims().update(claim)
        }
    }
}
En este último ejemplo se puede ver la implementación de autorización mediante annotations (en este caso solo pueden ejecutar el caso de uso aquellos usuarios que tengan el rol de administrador). Además se puede ver una anotación para feature flags: solo se puede ejecutar este caso de uso si la funcionalidad de reclamos está habilitada.
Estrategia de testing
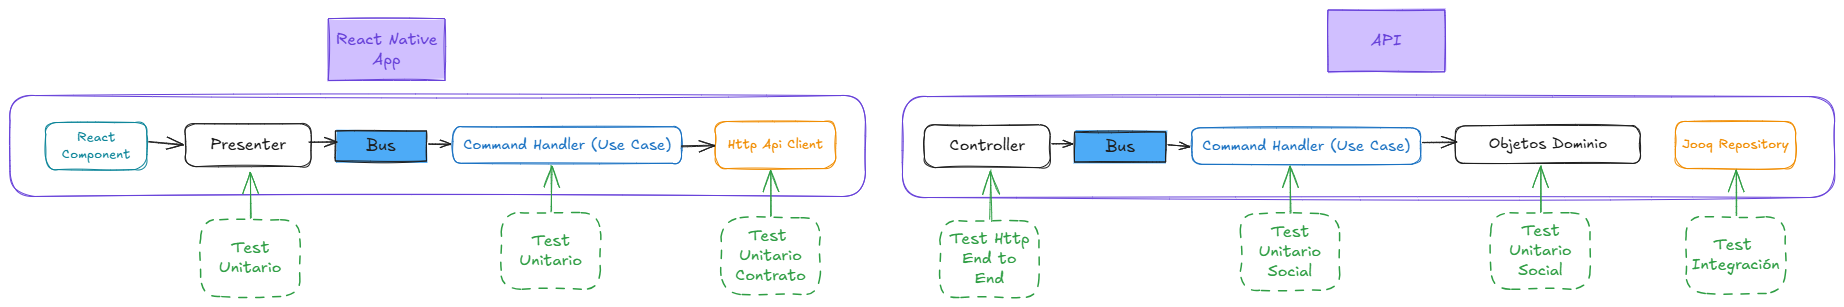
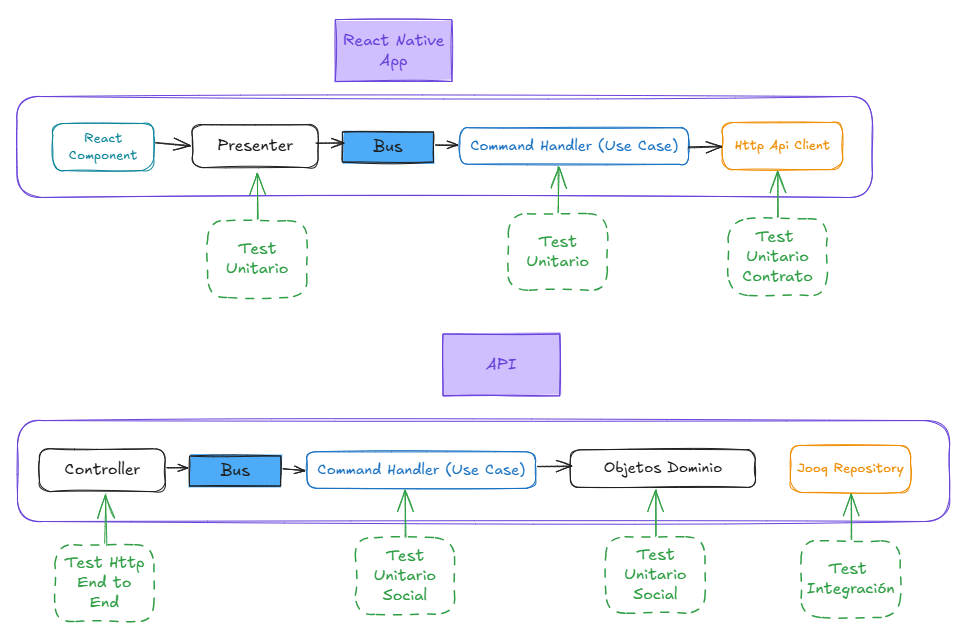
En este proyecto aplicamos TDD usando un balance entre Outside-In y TDD Clásico.
La estrategia es la siguiente:
- Primero se hace TDD sobre el presenter definiendo la lógica de la vista que contiene la funcionalidad que se desea desarrollar. Si este presenter necesita invocar casos de uso se usa un mock del bus.
- Luego se implementa el componente React (la maquetación) utilizando el presenter desarrollado.
- Luego se hace TDD sobre los nuevos comandos o queries que introdujo el presenter. Se mockean los clientes de la API (abstraídos en el dominio e implementados en la capa de infraestructura).
- Para terminar con el frontend se hace un test de contrato para implementar el cliente de la API (es la clase encargada de hacer el request HTTP a la API).
it('should load subjects on start', async () => {
    await presenter.start();

    verify(actionBus.query(new GetClaimSubjects())).called();
});

it('should show all subjects', async () => {
    const subject1 = newClaimSubject();
    const subject2 = newClaimSubject();
    when(actionBus.query(new GetClaimSubjects())).thenResolve([subject1, subject2]);

    await presenter.start();

    expect(view.model.subjects.length).toEqual(2);
    expect(view.model.subjects[0].id).toEqual(subject1.id);
    expect(view.model.subjects[1].id).toEqual(subject2.id);
});

it('should show loading while retrieving subjects', async () => {
    await presenter.start();

    expect(view.hasLoaded).toBeTrue();
    expect(view.model.isLoading).toBeFalse();
});

it('submit executes createClaim command', async () => {
    presenter.set({ subjectId: fixClaim.subjectId, description: fixClaim.description });

    await presenter.submit();

    verify(actionBus.exec(new CreateClaim(fixClaim.subjectId, fixClaim.description))).called();
});

it('show validation errors that occur on submit', async () => {
    when(actionBus.exec(anything())).thenReject(someValidationErrors);

    await presenter.submit();

    expect(view.model.errors).toEqual(someValidationErrors.allErrorMessages());
});

it('hide loading if submit fails', async () => {
    when(actionBus.exec(anything())).thenReject(someValidationErrors);

    await presenter.submit();

    expect(view.model.isLoading).toEqual(false);
});

it('show success message on success', async () => {
    await presenter.submit();

    expect(view.successMessageCalled).toBeTrue();
});
Luego de tener el frontend pasamos a implementar el backend (nuestros equipos son cross-funcionales y full-stack):
- Primero se hace un test end-to-end de la invocación de un caso de uso pero desde la capa HTTP. Estos tests son similares a los tests de aceptación de ATDD. Este test va a estar fallando hasta que se implementen todas las funcionalidades. Para estos tests usamos RestAssured que nos permite fácilmente ejecutar y analizar requests HTTP. Para armar el escenario ejecutamos comandos reales del core de la aplicación. Este test a medida que lo ejecutemos y vaya fallando nos va a ir indicando lo próximo a implementar.
- Hacemos TDD con tests sociables sobre los casos de uso (comandos, queries o event handlers). Si utilizan algo de la infraestructura usamos test doubles (por ejemplo una implementación del repositorio in-memory). En general el dominio se testea desde aquí indirectamente; los principales conceptos van apareciendo mediante el paso de refactoring.
- En algunos casos más complejos hacemos directamente TDD sobre objetos de dominio para descubrirlos y testear comportamientos que es muy difícil ver desde afuera.
- Finalmente, hacemos tests de integración sobre los objetos de infraestructura. Por ejemplo testeamos un repositorio real de jOOQ usando una base de datos real. Solemos usar transacciones para deshacer los cambios que hizo el test.
Ejemplo de test end-to-end:
class CloseClaimApiTest: BaseE2ETest() {
    @Test
    fun `admin can close claim`() {
        val response = request().asAdmin().post("/claims/$claimId/close").exec()

        response.assertThat().succeeds(200)
        assertThat(getClaim(claimId).isClosed).isTrue
    }

    @Test
    fun `send push notification when claim is closed`() {
        request().asAdmin().post("/claims/$claimId/close").exec()

        assertThat(pushNotificationSender.sentNotifications.first().message).startsWith("Su reclamo ha sido cerrado por el administrador")
    }

    private fun getClaim(claimId: Int) = repositories.claims().get(Id(claimId))

    private val user by lazy { scenario.user { deviceToken("123")} }
    private val claimId by lazy { scenario.claim { opened(); user(user) }.id.toInt() }
}
Ejemplo de test de un caso de uso:
class CloseClaimTest {
    @Test
    fun `should close claim with given id`() {
        val claim = scenario.claim { opened() }

        handler.execute(CloseClaim(claim.id), admin)

        val closedClaim = repositories.claims().get(claim.id)
        assertThat(closedClaim.isClosed).isTrue
    }

    @Test
    fun `should trigger ClaimClosed event`() {
        val claim = scenario.claim { opened() }

        handler.execute(CloseClaim(claim.id), admin)

        assert(eventBus.publishedEvents.any { it is ClaimClosed && it.claim.id == claim.id })
    }

    @Test
    fun `restricted to admin`() {
        assertThat(authorizedRoles<CloseClaim>()).contains(Roles.Admin)
    }

    private val eventBus = FakeEventBus()
    private val repositories = InMemoryRepositoryProvider(eventBus)
    private val scenario = ScenarioBuilder(repositories)
    private val handler = CloseClaim.Handler(repositories)
    private val admin = AdminIdentity()
}
Para la creación de escenarios en los tests de casos de uso y del dominio utilizamos test data builders y test examples.
object AddressExamples {
    val streets = TestExamples("Rivadavia 1234", "Campos Salles 2002", "Cabildo 777")
    val cities = TestExamples("Buenos Aires", "CABA", "Rosario", "Córdoba")
    val countryCodes = TestExamples(listOf("AR", "BR", "MX", "UY").map { CountryCode(it) })
    val zipCodes = TestExamples("6500", "1406", "1407", "6300")
    val addresses = TestExamples(List(10) { Address(streets.one(), cities.one(), countryCodes.one(), zipCodes.one()) })
}
Ejemplos de escenarios:
val user = scenario.user()
val unit = scenario.unit { tenants(user) }

// Complex scenario
val manager = scenario.manager {
  code(1234)
  name("Administración Varela")

  association {
    code(5678)
    name("Rivadavia 1900")
    contactInfo { address { street("Campos Rivadavia 1900") } }
    paymentProviders(
        CVUTransferProvider(),
        RedepagosProvider(),
        BankTransferProvider(fullnames.one(), taxIds.one(), transferNumbers.one(), transferAliases.one()),
        CashProvider()
    )
  }
}
Este último ejemplo muestra cómo, de forma declarativa, se puede crear una administración de consorcios (manager) junto con su correspondiente consorcio (association), especificando proveedores de pago, información de contacto y otros datos relacionados. Todo este flujo es agnóstico del entorno de ejecución: si se ejecuta en un test unitario, los objetos se crean en repositorios in-memory; pero si se ejecuta en un test de integración o end-to-end, se persisten en la base de datos real, en el orden adecuado y respetando las foreign keys correspondientes.
Para el control del tiempo en los tests modelamos una abstracción de reloj (Clock) donde en los tests usamos un StoppedClock que nos permite controlar explícitamente el reloj. En el código productivo usamos un SystemClock.
Metodología de trabajo
Trabajo con equipos cross-funcionales que tienen todos los roles necesarios para construir un producto: Product Owner, diseño gráfico y developers full-stack. Los programadores son generalistas-especialistas: si bien algunos tienen mayor conocimiento en mobile, web, backend o infraestructura, todos pueden colaborar en cualquier parte del código y manejan todos los temas. El Product Owner además hace QA exploratorio.
Trabajamos diariamente con pair y mob programming. Esto hace que el conocimiento fluya y que rápidamente todos aprendan todo.
Hacemos TDD e integración continua, no usamos feature branches en Git, hacemos micro-commits como parte del flujo de TDD y estos se integran en GitLab con un pipeline que revisa que esté todo bien.
Cuando algo falla en la única rama que tenemos (main) es prioridad del equipo entero solucionarlo. Main siempre está listo para ser desplegado. Cada commit que pasa el pipeline se despliega automáticamente al entorno de staging y se les notifica a los stakeholders para que puedan ver diariamente lo último y darle feedback al equipo.
Para mobile usamos Firebase App Distribution para que cada uno pueda tener en su celular siempre la última versión.
El deploy a producción se hace integrando el código a una rama especial llamada "production". Este proceso está 100% automatizado.
Como hacemos integración continua, micro-commits y TDD, el refactor del código es cotidiano, sucede con cada ciclo de TDD. Esto ayuda a que el código no acumule deuda técnica y vaya evolucionando a medida que vamos aprendiendo más sobre el negocio.
No usamos Scrum: tenemos un tablero Kanban con indicadores que nos indican cuándo debemos juntarnos a planificar otro lote de historias de usuario para agregar (planificación on-demand).
En cada columna del tablero tenemos un límite de WIP para evitar que las tarjetas se acumulen y detectar de forma temprana cuellos de botella. El flujo está optimizado para minimizar el lead-time y maximizar el throughput.
No estimamos. Sliceamos las historias de usuario para que su tamaño sea aproximadamente de 1 o 2 días. Para hacer pronósticos contabilizamos el throughput semanal (contando la cantidad de historias que pasaron a done en esa semana) y proyectamos en base a eso.
Casi no hacemos dailies, puesto que hablamos y trabajamos en equipo todos los días. Cada 2 semanas nos juntamos a hacer una retrospectiva para optimizar el proceso y detectar problemas.
Para la gestión del backlog usamos user story mapping.