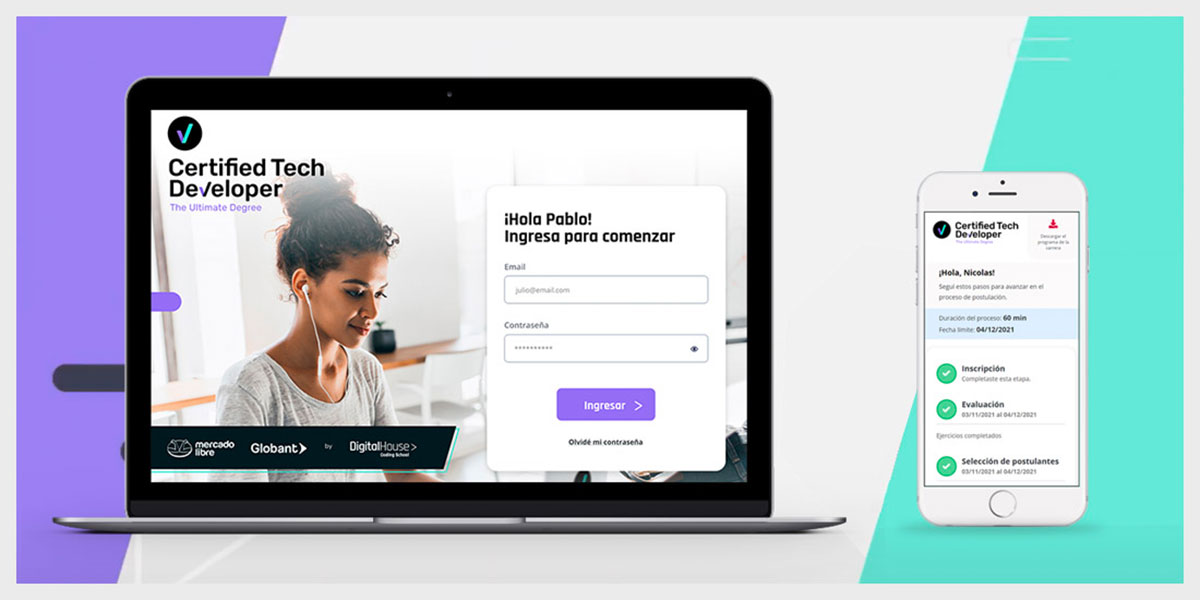
Digital House Certified Tech Developer
Introducción
Certified Tech Developer fue un proyecto educativo de gran escala impulsado por Digital House junto a Mercado Libre y Globant, con el objetivo de formar nuevos perfiles técnicos en Latinoamérica a través de una carrera intensiva en programación y habilidades digitales.
Desde nuestro rol, acompañamos a Digital House en uno de los desafíos más importantes del programa: escalar su proceso de onboarding para poder llegar a miles de postulantes en distintos países. Creamos una plataforma que permitió automatizar todo el flujo de incorporación de candidatos, desde la inscripción hasta la asignación de becas y el acceso al campus virtual.
El primer lanzamiento tenía una fecha comprometida públicamente y una campaña de difusión masiva, por lo que sabíamos que iba a recibir un volumen de tráfico muy alto desde el primer día. Era crítico garantizar la estabilidad de la plataforma. Por eso realizamos pruebas de stress y optimizamos los servicios clave para asegurar un rendimiento robusto bajo carga.
Mi rol fue de arquitectura, liderazgo técnico y participación activa en el desarrollo. Diseñé e implementé los componentes centrales de la solución y trabajé junto al equipo para garantizar que cada decisión técnica estuviera alineada con los objetivos de negocio, la calidad esperada y los tiempos del proyecto.
El impacto fue concreto: se lanzaron campañas en 7 países, se procesaron más de 100.000 inscripciones y se otorgaron 5.000 becas, contribuyendo de forma directa al posicionamiento regional del programa y a la formación de nuevos talentos digitales.
El lanzamiento tuvo mucha repercusión en los medios. Este es el video de presentación del programa.
Funcionalidades principales
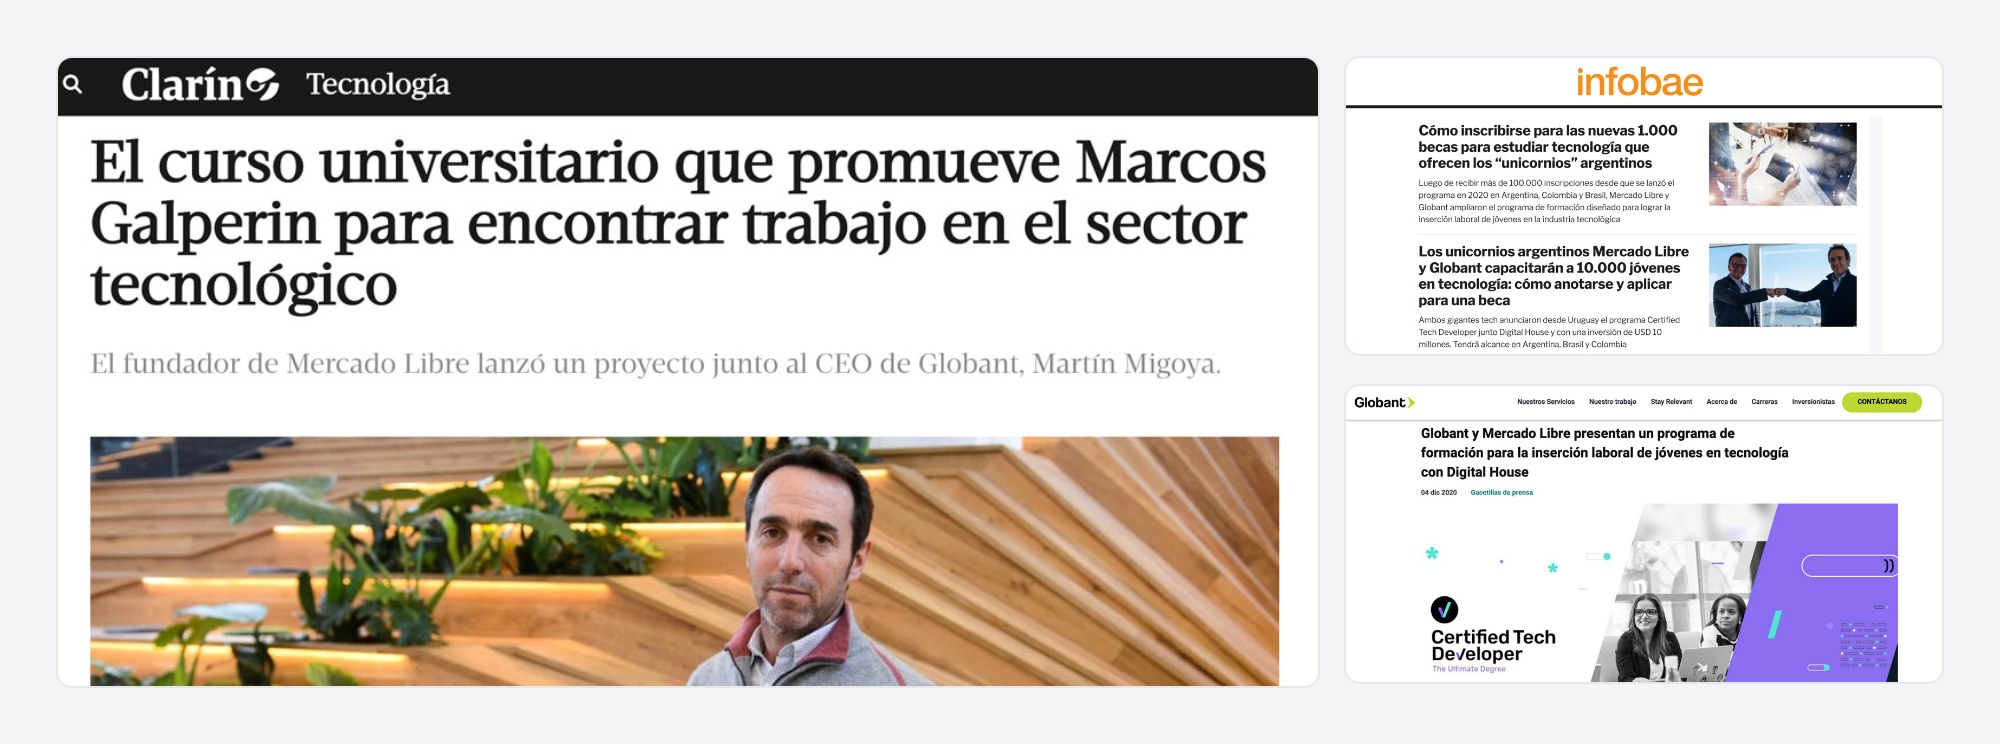
La plataforma automatizaba el proceso completo de incorporación de candidatos, desde la inscripción inicial hasta la asignación final de becas. Se diseñó con un enfoque modular y configurable para adaptarse a las necesidades cambiantes de cada campaña y país.
Permitía crear formularios de inscripción dinámicos, realizar evaluaciones automáticas a través de quizzes y tests técnicos, y gestionar presentaciones en video, entrevistas agendadas y evaluaciones gamificadas con inteligencia artificial. Cada paso contribuía a un sistema de puntajes que alimentaba un motor de reglas para la asignación de becas, considerando cupos y características específicas de los postulantes.
Además, incluía funcionalidades para el procesamiento de pagos online y la gestión simultánea de múltiples campañas y cohortes con flujos personalizados.
La plataforma se integraba con distintos sistemas internos de Digital House: CRM para el seguimiento de candidatos, sistema académico para la matriculación, Power BI para el análisis en tiempo real de los datos, y el sistema de Tesorería para validar pagos y otorgamientos. Todo el ecosistema trabajaba en conjunto para ofrecer una experiencia ágil, escalable y trazable.
Enfoque técnico
La plataforma de Certified Tech Developer fue desarrollada como una solución robusta y escalable para automatizar el proceso de onboarding de miles de candidatos en campañas simultáneas a nivel regional.
Elegí Kotlin como lenguaje principal del backend por su expresividad, productividad y equilibrio entre el paradigma orientado a objetos y funcional. Permite escribir código claro y declarativo, sin la verbosidad de Java.
Librerías por sobre frameworks
Evito utilizar frameworks, puesto que introducen mucha indirección, complejidad innecesaria y hacen perder el control de la aplicación (es el framework quien la controla). En su lugar, prefiero librerías livianas y un diseño simple, explícito y sostenible.
Para la capa web de la API utilicé Javalin, una librería minimalista que envuelve a Jetty, ideal para mantener bajo control el flujo de requests sin magia. Al no haber un framework en el medio teníamos acceso directo a Jetty, lo que nos permitió ajustar su configuración para soportar la carga del lanzamiento.
Pruebas de stress
El lanzamiento tenía fecha fija, anunciada en los medios, y el respaldo de Mercado Libre y Globant. Antes de salir necesitábamos saber cuánta carga soportaba la plataforma y dónde se rompía.
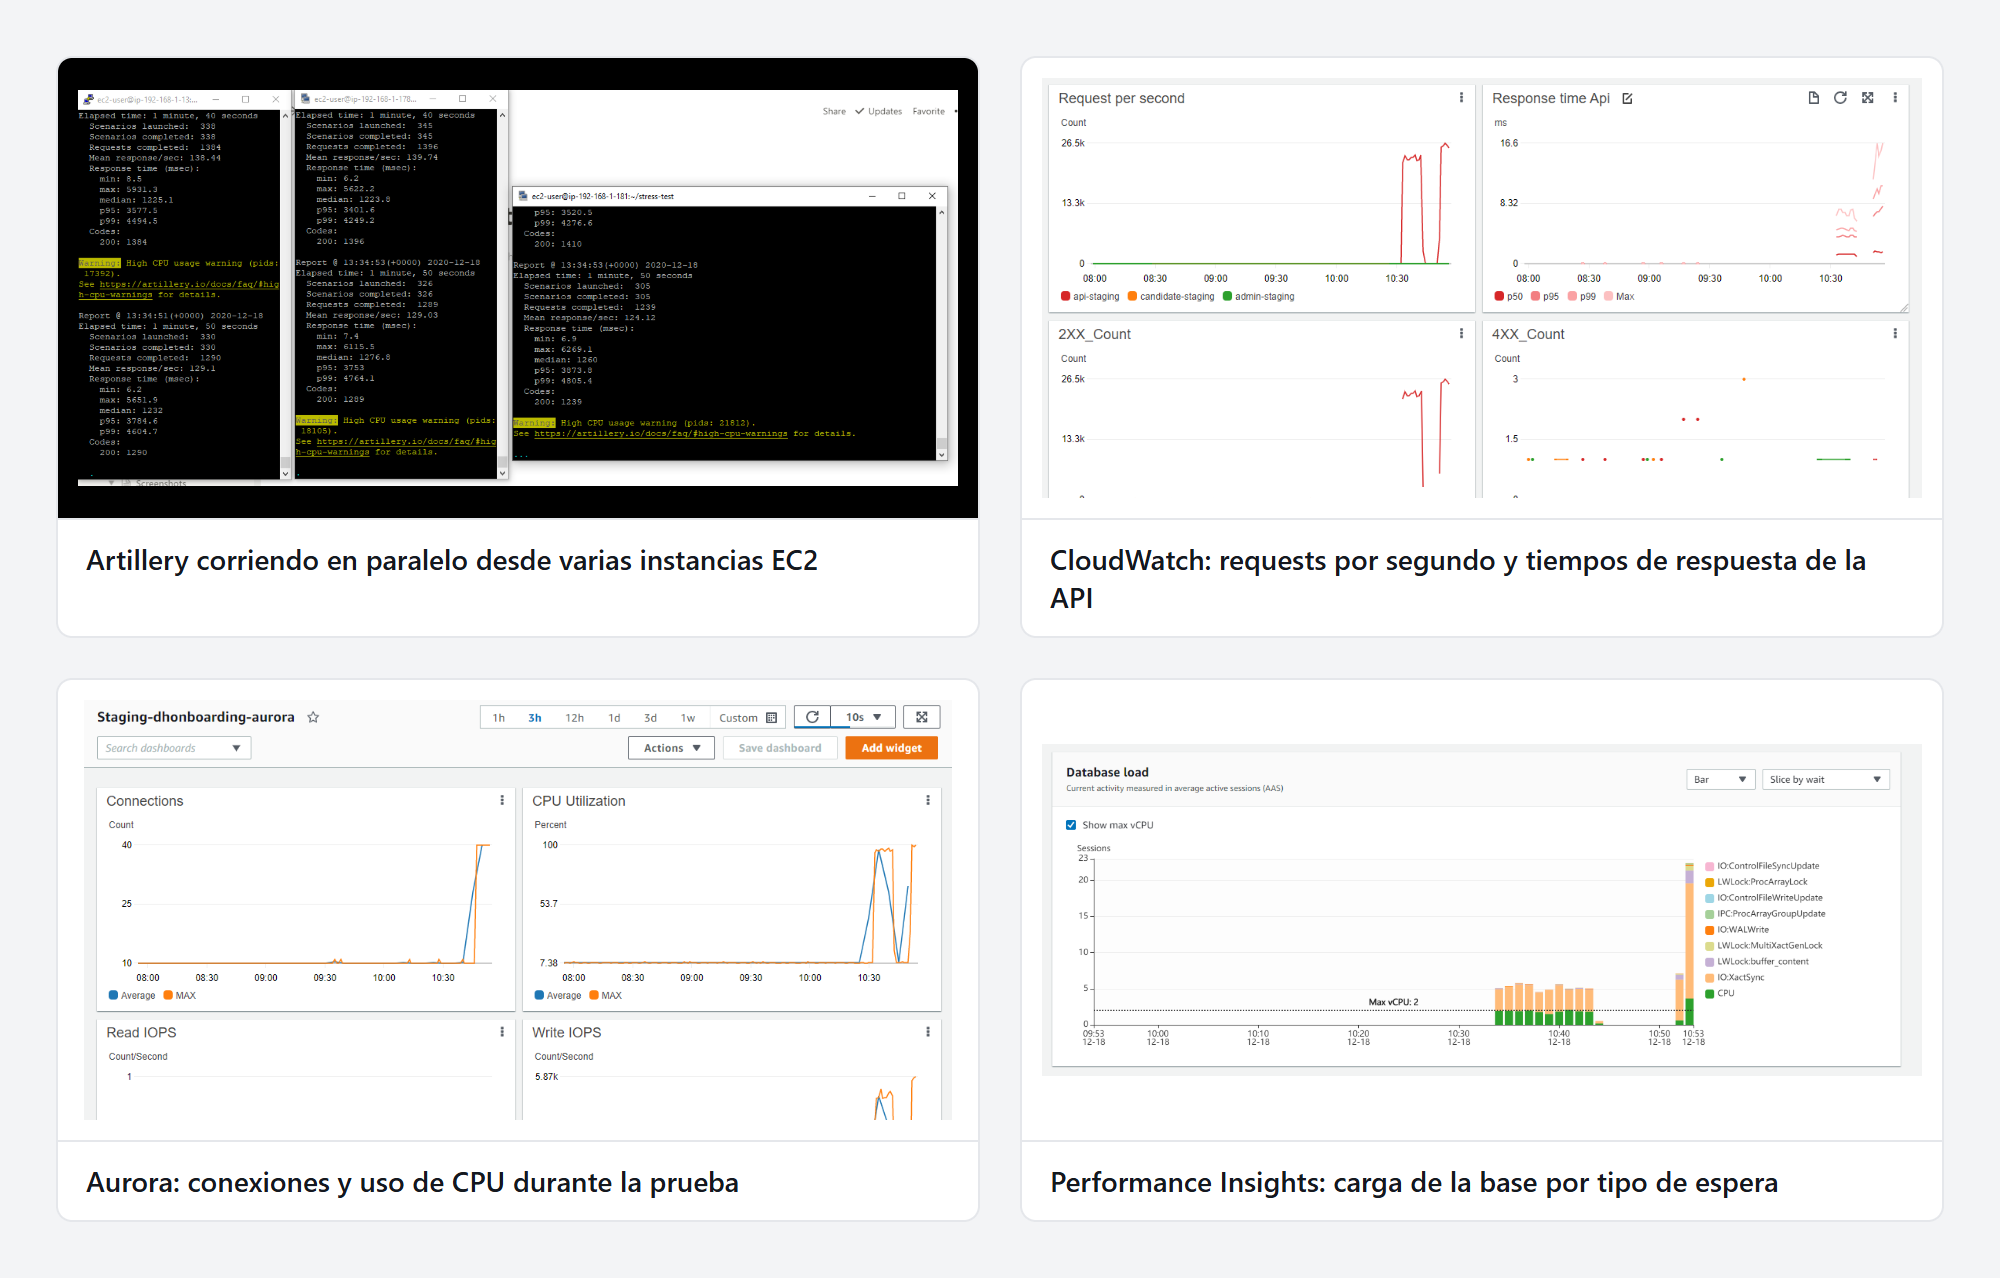
Armé los escenarios con Artillery y los ejecutamos en paralelo desde varias instancias EC2 contra el entorno de staging (una sola máquina no alcanzaba para generar la carga). Fuimos iterando: correr la prueba, mirar las métricas en CloudWatch y Performance Insights, ajustar y volver a correr, subiendo la carga en cada vuelta.
Primero probamos la carga del formulario de inscripción, que era lo primero que recibía el pico de tráfico:
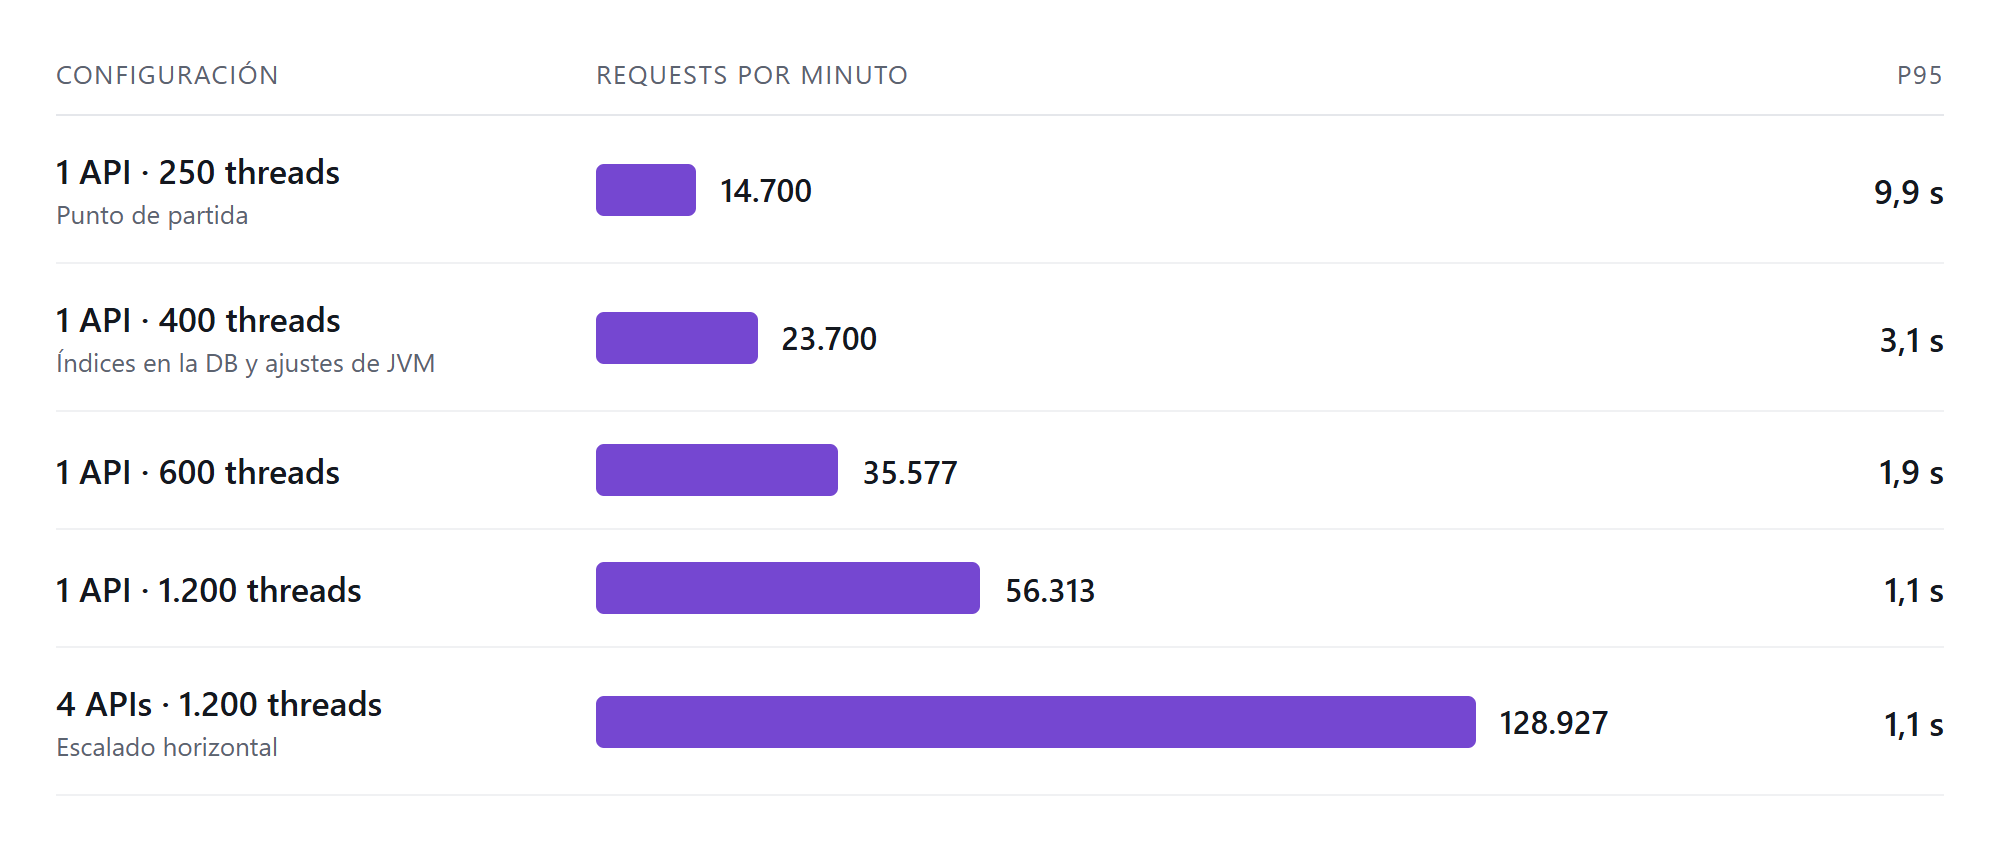
Los cambios que más impacto tuvieron:
- Índices en la base de datos y ajustes de la JVM.
- Tuning del thread pool de Jetty (de 250 a 1.200 threads) y un puerto de management con su propio thread pool, para que los health checks de ECS no compitieran con el tráfico real.
- Escalado horizontal: con 4 instancias de la API procesamos casi 130.000 requests por minuto sin errores y con la CPU de la API por debajo del 40%.
Después probamos el flujo completo de inscripción. Ahí el cuello de botella pasó a ser la base de datos: con una sola instancia de la API se procesaban unas 6.250 inscripciones por minuto y la CPU de la base llegaba al 97%. La solución fue pasar a una instancia con más CPU.
Persistencia
Para la persistencia, descarté el uso de ORMs: introducen sobreingeniería, esconden el SQL y promueven un modelo inadecuado para dominios ricos. En su lugar usamos jOOQ, un DSL de SQL tipado que permite mantener control total sobre las consultas, integrándolo con el patrón Repository para encapsular el acceso a datos de forma clara y mantenible. Los ORMs suelen mapear tablas a estructuras de datos, no a objetos ricos de dominio. Prefiero separar explícitamente las capas y modelar el dominio con intención.
Utilizamos PostgreSQL como base de datos y Flyway para el versionado. Usamos réplicas de solo lectura para distribuir la carga. Implementamos CQRS: los comandos de escritura operaban sobre la base principal, mientras que las lecturas se derivaban a réplicas configuradas específicamente para esa carga. Para aliviar todavía más a la base sumamos Redis como cache de las entidades que se consultaban con más frecuencia.
Inyección de dependencias explícita
No utilizo contenedores de inyección de dependencias. Con una arquitectura clara, la inyección manual de dependencias es sencilla y minimiza la indirección. Esto mejora la legibilidad del sistema y el seguimiento de los flujos de ejecución.
Herramientas auxiliares
Desarrollé una herramienta CLI en JavaScript: una consola de desarrollo que automatizaba tareas frecuentes y nos ayudó a mejorar la productividad. Este CLI también permitía ejecutar comandos remotos de mantenimiento en los distintos ambientes (administración de campañas, importación de datos, etc.). Además, creé PopulateDB, una utilidad que permitía inicializar la base de datos de desarrollo con distintos escenarios y contextos, facilitando el desarrollo y la validación de funcionalidades en distintos casos de uso.
CI/CD y despliegue
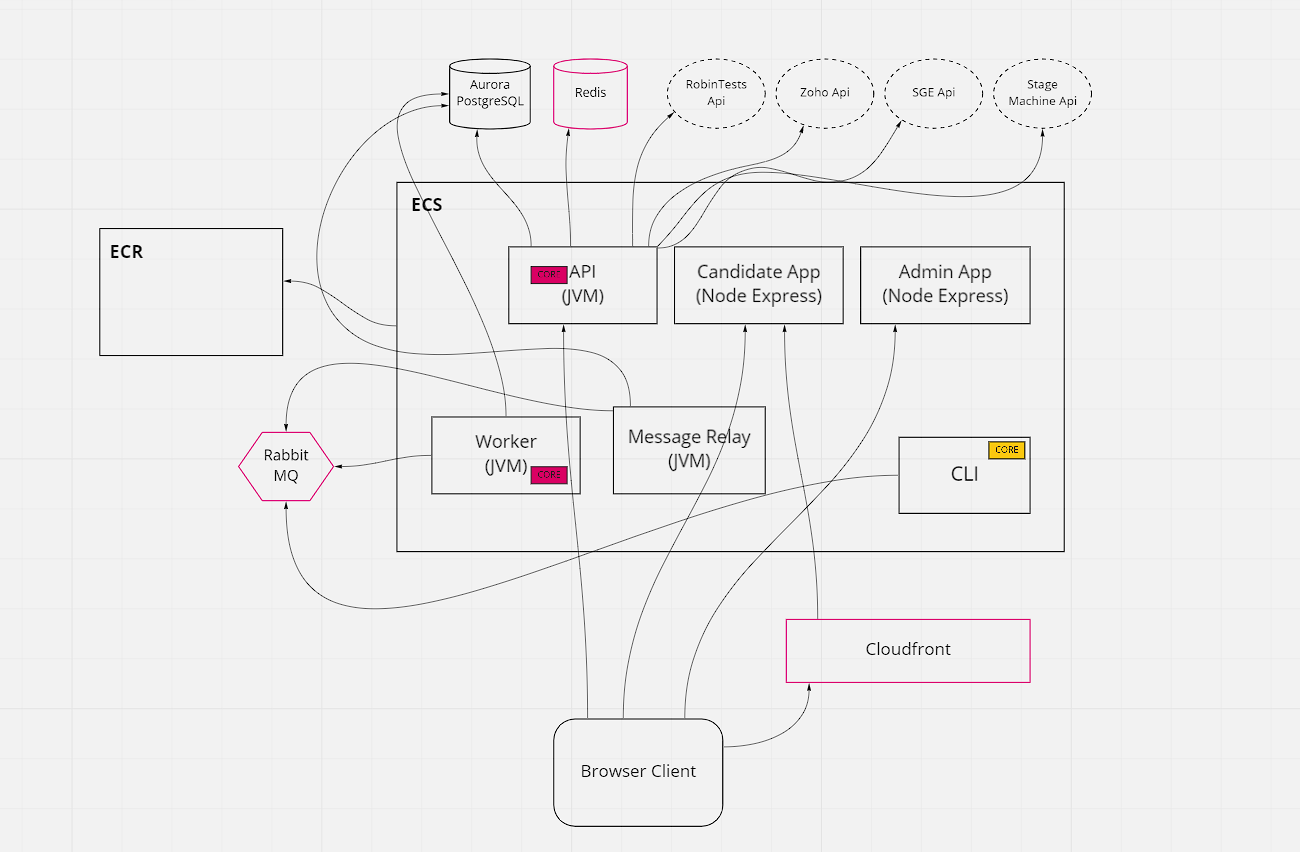
Utilizamos AWS como plataforma cloud, con ECS para orquestación de contenedores, ECR para imágenes Docker, CloudWatch con dashboards custom para monitoreo, RabbitMQ, Redis y Aurora como base de datos. Automatizamos el aprovisionamiento completo de los entornos de staging y producción con Terraform, incluyendo configuración de servicios, redes (VPC), reglas de firewall y dependencias.
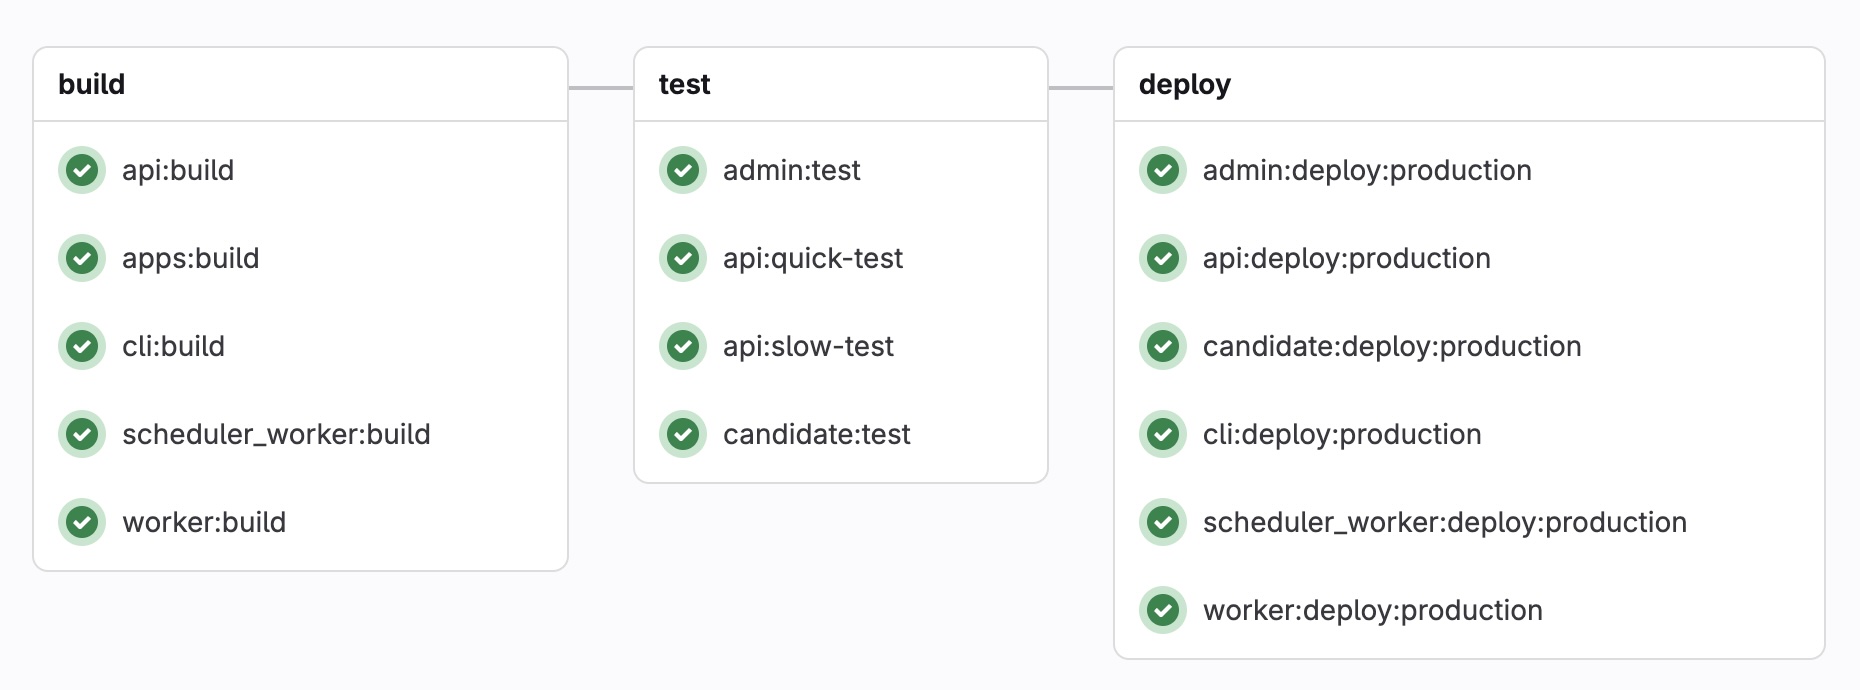
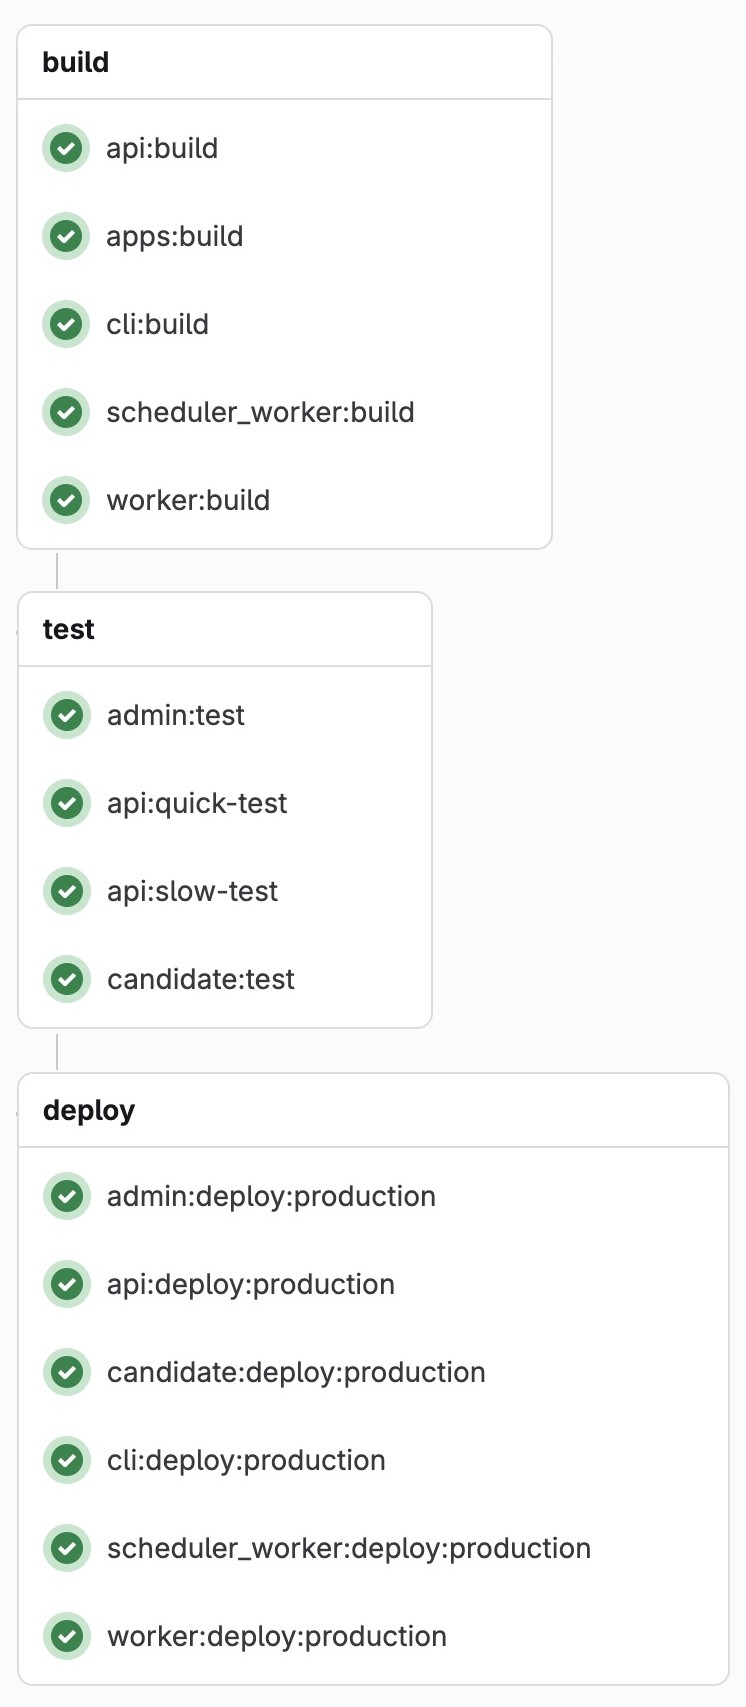
El pipeline de CI/CD fue implementado en GitHub Actions e incluía:
- Ejecución automática de tests unitarios, de integración y end-to-end
- Construcción de imágenes Docker versionadas y subida a ECR
- Despliegue automatizado en ECS
- Ejecución de migraciones con Flyway cuando correspondía
- Provisioning completo de staging en cada cambio de infraestructura
- Paso de aprobación manual para producción, con visualización del diff de Terraform antes de aplicar los cambios
Monitoreo y operación
Creamos múltiples dashboards en CloudWatch para monitoreo en tiempo real del sistema, incluyendo métricas de infraestructura, salud de servicios, colas de eventos y uso de recursos.
Monorepo
Utilizamos un monorepo para agrupar todos los componentes del sistema: backend, frontend web, backoffice y herramientas internas. Esto simplificó enormemente el setup local (que se hacía con un solo comando), favoreció el versionado sincronizado de cambios y facilitó el desarrollo full-stack.
Arquitectura
El backend era un monolito modular. Cada módulo correspondía a un Bounded Context (admisión, identidad y accesos, contenidos, reportes y tracking) y tenía su propia API y su propio core. Se desplegaban juntos, lo que nos evitó la complejidad operativa de los microservicios sin perder la separación entre contextos.
Dentro de cada módulo apliqué Domain-Driven Design y organicé el código siguiendo los principios de Clean Architecture.
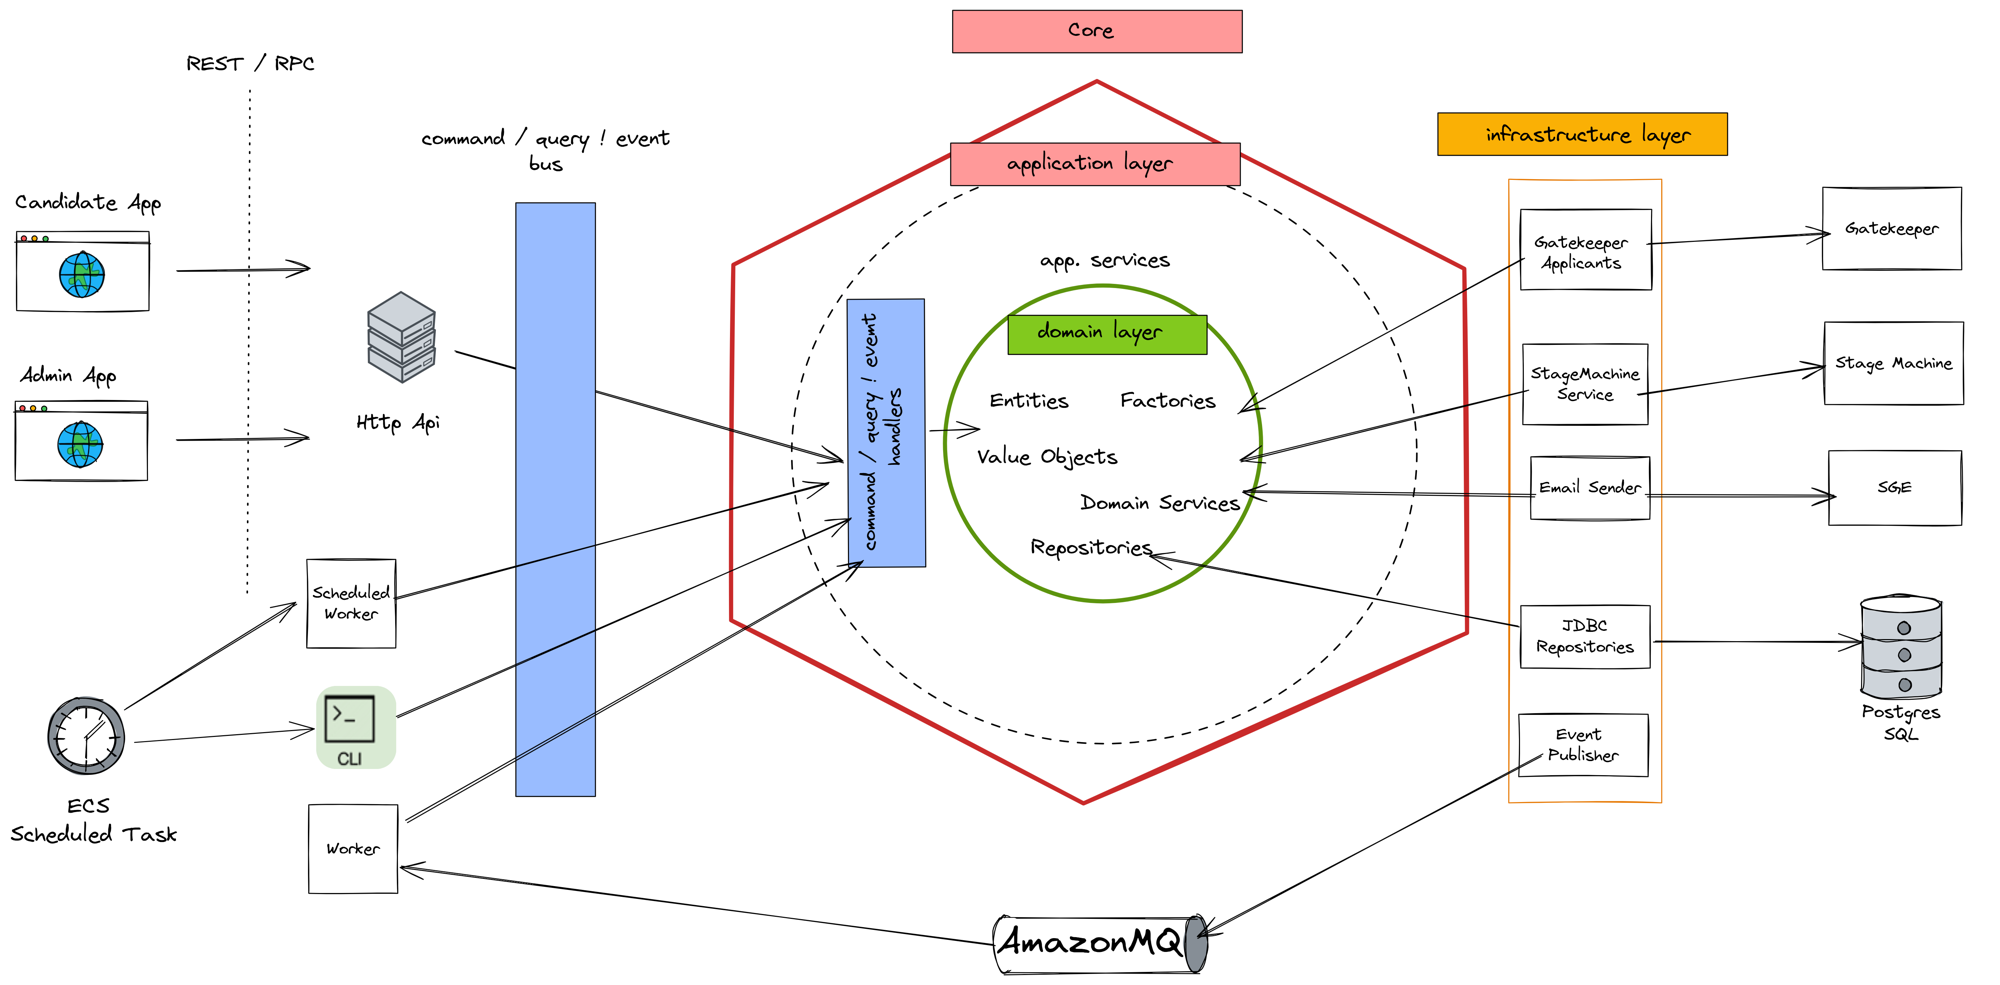
- La aplicación de candidatos y el backoffice se comunicaban con la API HTTP, que funcionaba como mecanismo de delivery.
- Los controllers eran livianos: interpretaban el request y lo traducían a un comando o query.
- Un bus enrutaba cada comando o query al handler correspondiente (caso de uso).
- Por ese mismo bus entraban el worker (que procesaba eventos), las tareas programadas de ECS y el CLI de mantenimiento. Todos ejecutaban los mismos casos de uso; no había lógica duplicada según el punto de entrada.
- El dominio contenía el corazón del sistema: entidades, value objects, servicios de dominio y eventos.
Las integraciones con los sistemas de Digital House, los repositorios y la publicación de eventos estaban en la capa de infraestructura. Como las dependencias estaban invertidas (la infraestructura dependía del dominio y no al revés), el dominio no se enteraba de con qué sistema externo estaba hablando.
Los eventos de dominio se publicaban en RabbitMQ y el worker los procesaba de forma asíncrona. Esto permitía sacar del request todo lo que no necesitaba ser inmediato, como las notificaciones.
En el frontend usé la misma arquitectura que en otros proyectos: React como librería de UI y la lógica de vista en Presenters, clases de TypeScript puras sin dependencia de React.
Estrategia de testing
Aplicamos TDD en todo el proyecto. Los tests del backend estaban separados en dos grupos:
- Tests rápidos: casos de uso y dominio, usando test doubles para la infraestructura (por ejemplo repositorios in-memory).
- Tests lentos: tests de integración sobre la infraestructura real, por ejemplo los repositorios de jOOQ contra un PostgreSQL real.
El pipeline corría los dos grupos en cada commit antes de desplegar.
Metodología de trabajo
Trabajé con equipos cross-funcionales que tenían todos los roles necesarios para construir un producto: Product Owner, diseño gráfico y developers full-stack. Los programadores eran generalistas-especialistas: si bien algunos tenían mayor conocimiento en web, backend o infraestructura, todos podían colaborar en cualquier parte del código y manejaban todos los temas.
Trabajábamos diariamente con pair y mob programming. Esto hacía que el conocimiento fluyera y que rápidamente todos aprendieran todo.
Hacíamos TDD e integración continua, no usábamos feature branches en Git, hacíamos micro-commits como parte del flujo de TDD y estos se integraban en GitHub con un pipeline que revisaba que estuviera todo bien.
Cuando algo fallaba en la única rama que teníamos (main) era prioridad del equipo entero solucionarlo. Main siempre estaba listo para ser desplegado. Cada commit que pasaba el pipeline se desplegaba automáticamente al entorno de staging, para que los stakeholders pudieran ver diariamente lo último y darle feedback al equipo.