Culti
Introducción
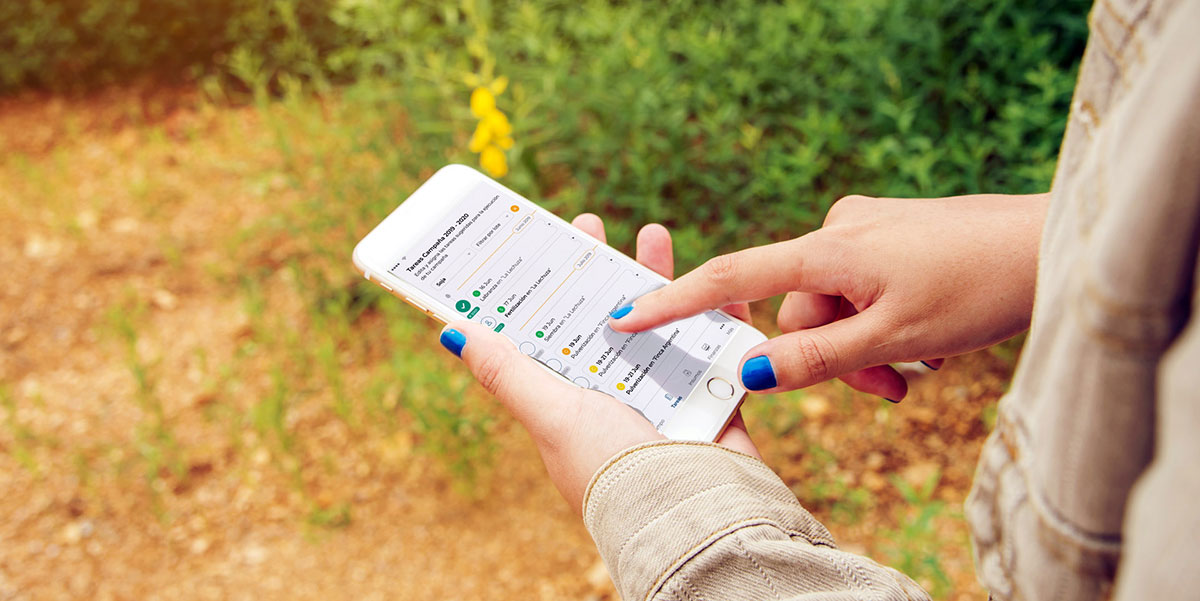
Culti era una plataforma agropecuaria inteligente y colaborativa que desarrollamos desde cero como socios tecnológicos. Se trataba de una solución web y mobile que acompañaba al productor en todo el ciclo productivo, facilitando la planificación, la gestión operativa y la comercialización, con foco en la toma de decisiones basada en datos.
Desde el inicio, acompañamos al equipo fundador, realizando juntos el proceso de discovery. A partir de allí, tomé el liderazgo técnico: diseñé la arquitectura desde cero, implementé los componentes clave del sistema y formé al equipo de desarrollo. A lo largo del proyecto, apliqué prácticas de excelencia técnica para construir una base sólida, extensible y preparada para escalar.
¿Qué resolvía Culti?
En el agro, muchos productores todavía operan con Excel, herramientas aisladas o procesos manuales. Esto genera:
- Información dispersa o desactualizada
- Dificultad para tomar decisiones en tiempo real
- Falta de planificación financiera
- Gestión ineficiente de tareas, insumos y comercialización
Culti proponía una transformación profunda, basada en:
- Información de valor en tiempo real
- Automatización de procesos operativos y administrativos
- Recomendaciones contextuales e insights personalizados
- Benchmarking y reportes inteligentes
Principales funcionalidades
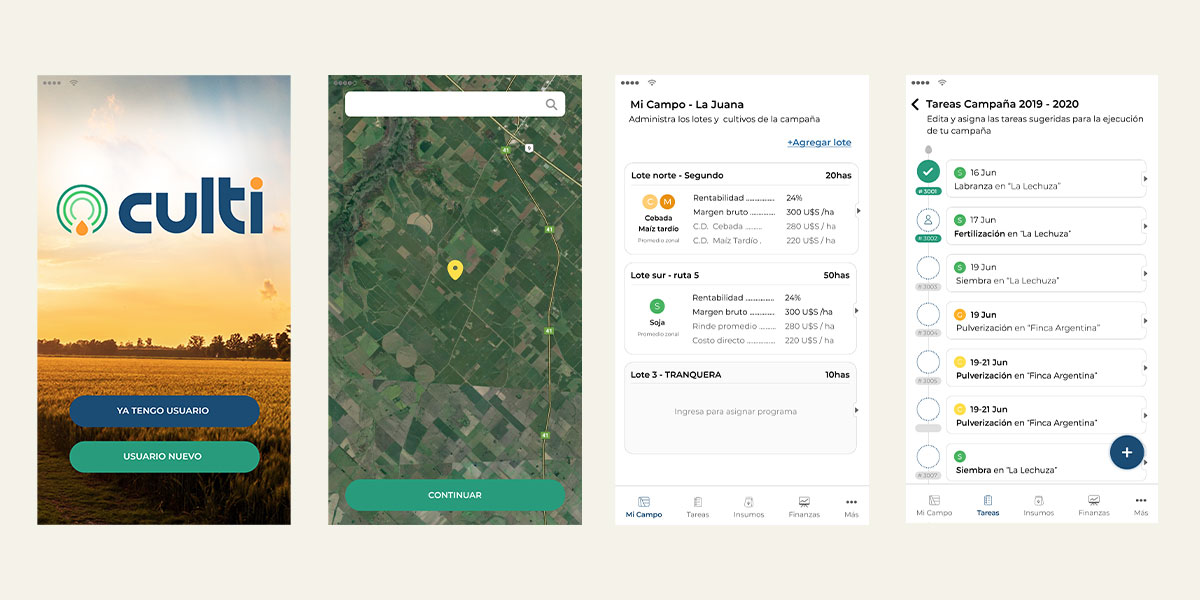
Culti cubría todas las etapas del ciclo productivo con un enfoque práctico, diseñado para el contexto real del campo:
- Planificación de campaña: definición de qué sembrar, dónde y con qué prácticas. Generación automática del plan de tareas y requerimientos de insumos. Planes agrarios recomendados por ingenieros especializados.
- Presupuesto y control de costos: estimación detallada de gastos por lote o cultivo, con seguimiento del desvío real.
- Gestión de tareas y operaciones: asignación de tareas, seguimiento de ejecución y carga automática desde el campo.
- Inventarios: control de insumos y granos cosechados, con stock en tiempo real.
- Comercialización: seguimiento de precios, sugerencias de venta y herramientas para reducir el riesgo comercial.
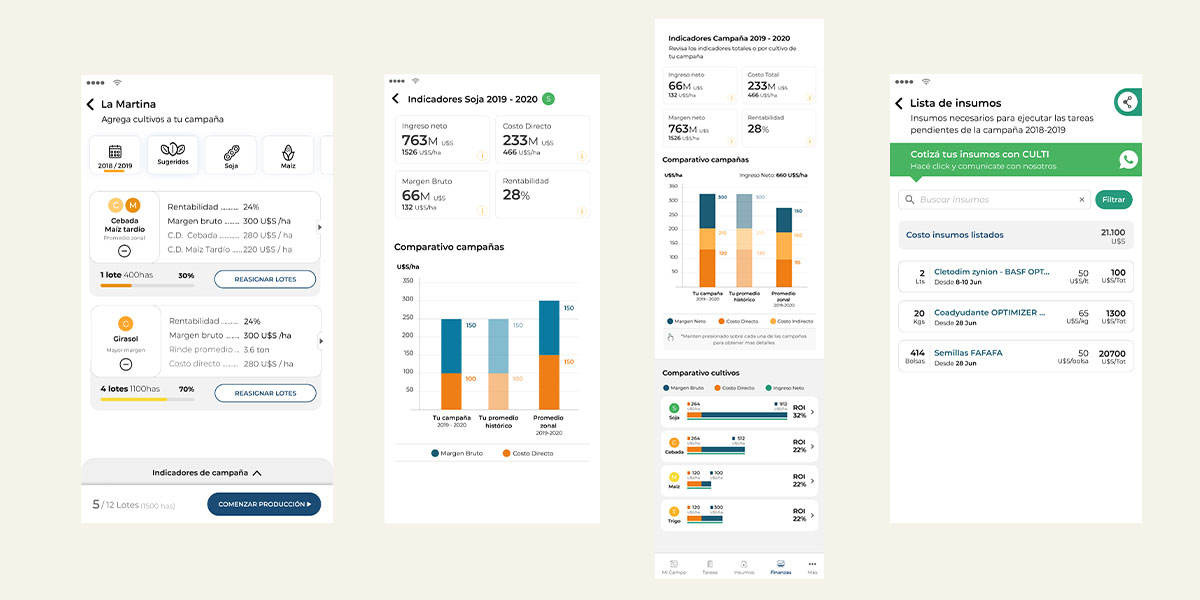
- Reportes y recomendaciones: informes estandarizados, comparaciones con promedios zonales y sugerencias contextuales del sistema.
Alcance e impacto
Aunque el proyecto no logró consolidarse como negocio, en su fase activa alcanzó métricas que mostraban un interés inicial relevante:
- +4.500 descargas
- +1.400 campos registrados
- +150.000 hectáreas gestionadas
El producto buscaba facilitar mejores decisiones técnicas y comerciales, optimizar costos y liberar tiempo operativo.
Enfoque técnico
Culti estaba compuesto por una aplicación mobile (Android e iOS) desarrollada en React Native, una aplicación web construida con React y una API desarrollada en Kotlin sobre la JVM.
Elegí Kotlin como lenguaje principal del backend por su expresividad, productividad y equilibrio entre el paradigma orientado a objetos y funcional. Permite escribir código claro y declarativo, sin la verbosidad de Java.
Librerías por sobre frameworks
Evito utilizar frameworks, puesto que introducen mucha indirección, complejidad innecesaria y hacen perder el control de la aplicación (es el framework quien la controla). En su lugar, prefiero librerías livianas y un diseño simple, explícito y sostenible.
Para la capa web de la API utilicé Javalin, una librería minimalista que envuelve a Jetty, ideal para mantener bajo control el flujo de requests sin magia.
Persistencia
Para la persistencia, descarté el uso de ORMs: introducen sobreingeniería, esconden el SQL y promueven un modelo inadecuado para dominios ricos. En su lugar usamos jOOQ, un DSL de SQL tipado que permite mantener control total sobre las consultas, integrándolo con el patrón Repository para encapsular el acceso a datos de forma clara y mantenible. Los ORMs suelen mapear tablas a estructuras de datos, no a objetos ricos de dominio. Prefiero separar explícitamente las capas y modelar el dominio con intención.
Utilizamos PostgreSQL como base de datos y Flyway para el versionado.
Inyección de dependencias explícita
No utilizo contenedores de inyección de dependencias. Con una arquitectura clara, la inyección manual de dependencias es sencilla y minimiza la indirección. Esto mejora la legibilidad del sistema y el seguimiento de los flujos de ejecución.
Herramientas auxiliares
Desarrollé una herramienta CLI en JavaScript: una consola de desarrollo que automatizaba tareas frecuentes y nos ayudó a mejorar la productividad.
CI/CD y despliegue
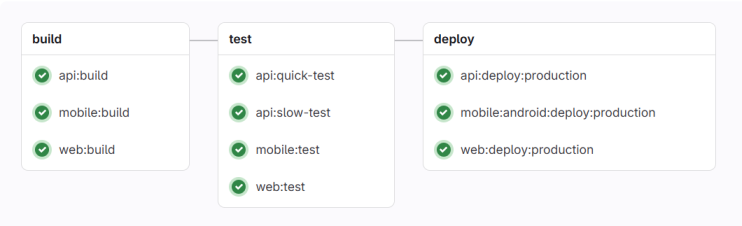
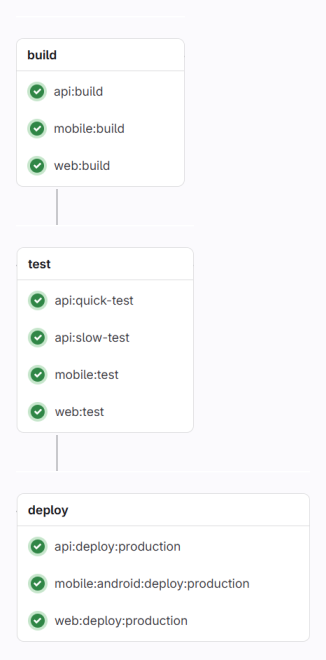
Utilizamos Heroku como plataforma en la nube tanto para staging como para producción. Implementé un pipeline de integración y despliegue continuo utilizando GitLab CI. Este pipeline:
- Ejecutaba tests automáticos (unitarios, end-to-end y de integración) y chequeos de calidad de código
- Construía imágenes de Docker versionadas
- Deployaba automáticamente a Heroku
- Ejecutaba migraciones pendientes de Flyway de ser necesario
Monorepo
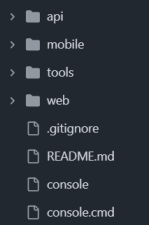
Utilizamos un monorepo para agrupar todos los componentes del sistema: backend, frontend web, mobile y herramientas internas. Esto simplificó enormemente el setup local (que se hacía con un solo comando), favoreció el versionado sincronizado de cambios y facilitó el desarrollo full-stack.
Arquitectura
Dado que el dominio era complejo y con reglas específicas, decidí aplicar Domain-Driven Design y organizar el sistema siguiendo los principios de Clean Architecture. Sus beneficios son múltiples:
- Separación clara de responsabilidades
- Independencia de decisiones tecnológicas (permitiendo que el proyecto sobreviva mejor al paso del tiempo)
- Gestión de dirección de dependencias desde los detalles de bajo nivel a los conceptos de alto nivel
- Facilidad de testing y evolución
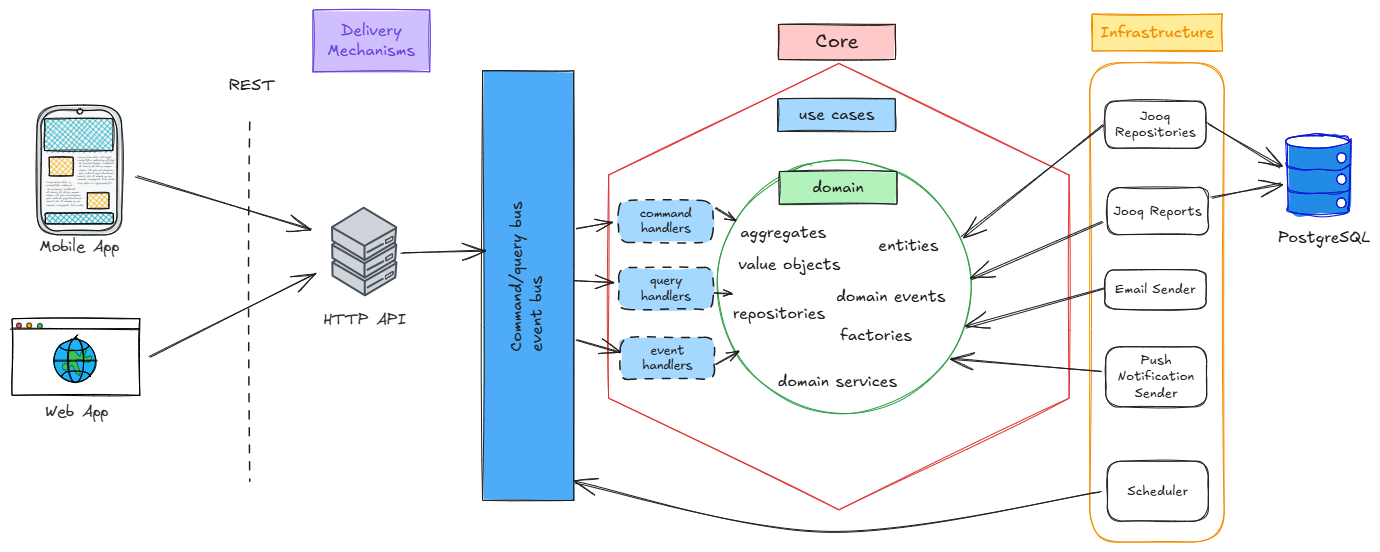
Tanto las aplicaciones mobile como web se comunicaban con la API REST, que funcionaba como mecanismo de delivery.
- La capa web de la API contenía controllers livianos que interpretaban los requests y los traducían a comandos o queries.
- Estos comandos/queries se enrutaban mediante un bus que invocaba al handler correspondiente (caso de uso).
- Los casos de uso coordinaban la ejecución de la lógica necesaria del dominio.
- El dominio contenía el corazón del sistema: modelos ricos, reglas de negocio, servicios de dominio y generación de eventos.
La responsabilidad de los casos de uso es implementar la lógica de aplicación (no de negocio). Son coordinadores: activan las funcionalidades de dominio necesarias.
El dominio modela el negocio y su lógica. Se usa el principio de inversión de dependencias para implementar aquellos servicios que requieren algún aspecto tecnológico (persistencia, notificaciones, servicios externos). Las implementaciones de estas tecnologías están en la capa de infraestructura. Como las dependencias están invertidas (la infraestructura depende del dominio y no al revés), es muy sencillo cambiar decisiones tecnológicas: se modifica la configuración de la aplicación indicando qué tecnología se quiere utilizar.
Arquitectura frontend
En el frontend, la lógica de negocio es limitada, pero la velocidad de cambio tecnológico es alta. Por eso adopté una versión más liviana de Clean Architecture. Los beneficios son similares a los de backend, pero en frontend tienen un impacto aún mayor por la velocidad de cambio tecnológico y la fragilidad de los tests de UI.
Este diseño me permitió aplicar TDD de forma efectiva, reducir el acoplamiento y mantener la agilidad del equipo frente a cambios.
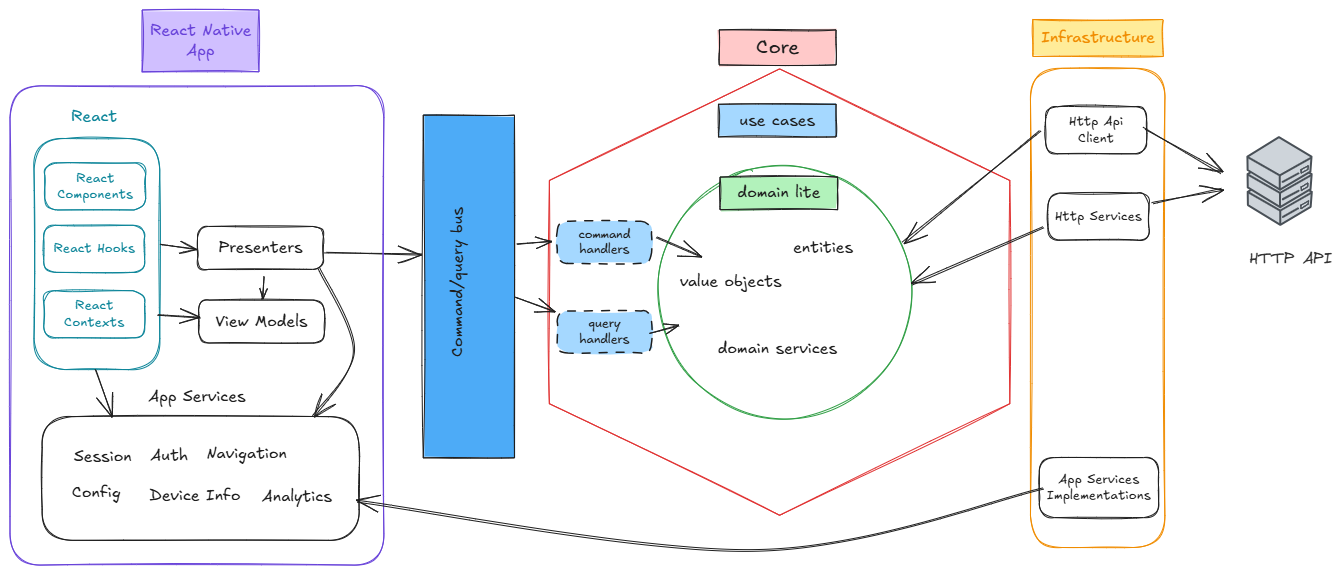
Uso React no como framework sino como librería de UI. Casi no uso hooks, ni librerías de manejo de estado. La lógica de vista se encapsula en Presenters: clases de TypeScript puras, sin ninguna dependencia de React. Los Presenters invocan casos de uso para activar lógica de negocio (que puede ser local o remota en la API), formatean los datos y exponen ViewModels con la información ya lista para mostrar.
Esta estructura permite reemplazar React por otra tecnología o versión sin reescribir la lógica, facilita el testing y desacopla la app del framework. Cambiar React por Vue, por ejemplo, sería reemplazar la capa de React. No habría que modificar ningún Presenter, ViewModel ni App Service.
Esto permite que la aplicación sobreviva al paso del tiempo pudiendo adaptarse a las nuevas tecnologías rápidamente.
Modelado de dominio
Culti tenía un modelo de dominio muy rico.
- Modelamos los ids como value objects (esto modela de forma explícita la identidad de una entidad, que sobrevive al paso del tiempo y los cambios en sus características).
- El dominio modelaba mucha lógica financiera. Creamos value objects para conceptos de negocio como costos, precios, montos, monedas. Esto permitió centralizar la lógica relacionada con estos datos puesto que los value objects funcionan como atractores de comportamiento.
- Si bien no implementé CQRS en este proyecto, para consultas complejas en vez de utilizar repositorios modelé los reportes. Un reporte se implementaba en la capa de infraestructura ejecutando directamente consultas complejas en la DB.
- Modelé eventos de dominio para quitar acoplamiento en los casos de uso y hacer más explícitas ciertas políticas de negocio.
class FieldFinancials(private val field: Field, private var grainId: GrainId?) {
  fun grossIncome(): Money {
    if (grainId == null) { return field.indicators.grossIncomePerHectare * field.hectares }
    return field.grainIndicators.single { it.grainId == grainId }.grossIncomePerHectare * field.hectares
  }

  fun marketingCost(): Cost {
    if (grainId == null) { return field.indicators.marketingCostPerHectare * field.hectares }
    return field.grainIndicators.single { it.grainId == grainId }.marketingCostPerHectare * field.hectares
  }

  fun indirectCost(): Cost {
    if (grainId == null) { return field.indicators.indirectCostPerHectare * field.hectares }
    return field.grainIndicators.single { it.grainId == grainId }.indirectCostPerHectare * field.hectares
  }

  fun hectares() = field.hectares

  fun isPlanned() = field.isPlanned()

  fun hasGrain(grainId: GrainId) = field.hasGrain(grainId)

  fun fieldId() = field.id

  fun scopedBy(grainId: GrainId) = FieldFinancials(field, grainId)
}
Estrategia de testing
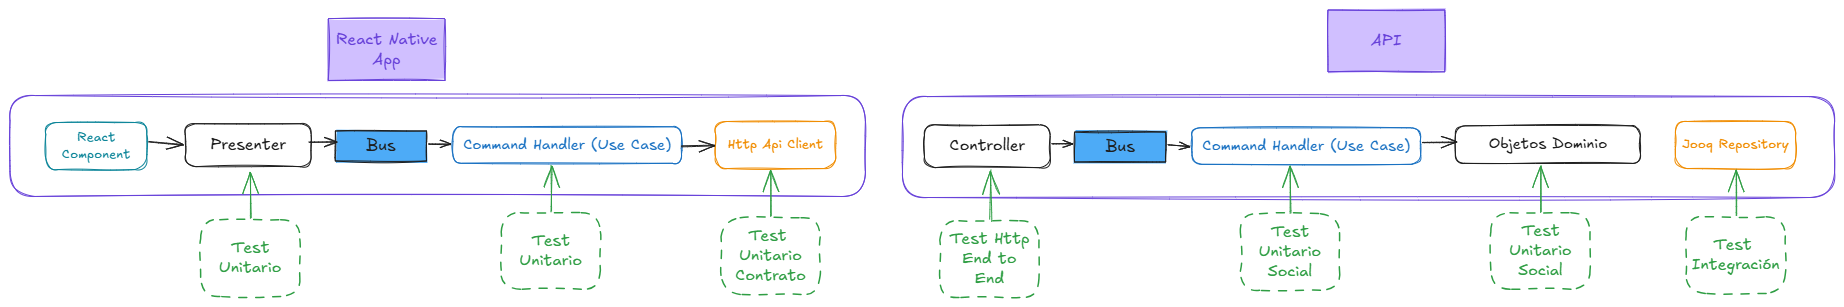
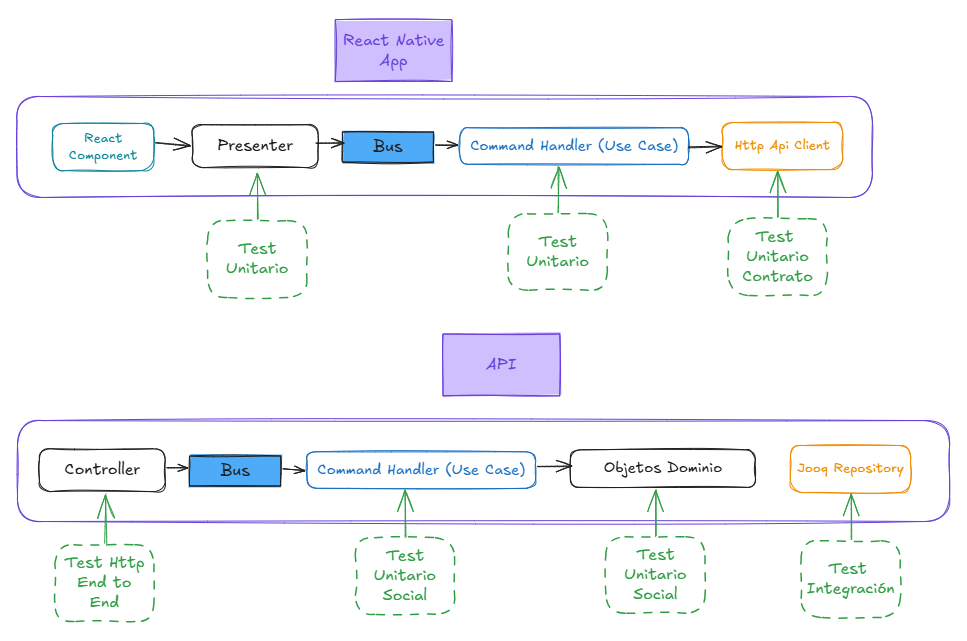
En este proyecto aplicamos TDD usando un balance entre Outside-In y TDD Clásico.
La estrategia era la siguiente:
- Primero se hacía TDD sobre el presenter definiendo la lógica de la vista que contenía la funcionalidad que se deseaba desarrollar. Si este presenter necesitaba invocar casos de uso se usaba un mock del bus.
- Luego se implementaba el componente React (la maquetación) utilizando el presenter desarrollado.
- Luego se hacía TDD sobre los nuevos comandos o queries que introdujo el presenter. Se mockeaban los clientes de la API (abstraídos en el dominio e implementados en la capa de infraestructura).
- Para terminar con el frontend se hacía un test de contrato para implementar el cliente de la API (era la clase encargada de hacer el request HTTP a la API).
describe('CreateFarmPresenter should', () => {
    it('navigate to PlanEditor on success save', async () => {
        await presenter.start()

        await presenter.save(SOME_FARM_NAME)

        verify(viewMock.navigateToSelectFarmLocation(SOME_FARM_NAME)).called()
    });

    it('notify view that saving failed because the name is not valid', async () => {
        await presenter.start()

        await presenter.save(SOME_EMPTY_FARM_NAME)

        verify(viewMock.showError(anything())).called()
    })
})
Luego de tener el frontend pasamos a implementar el backend (nuestros equipos eran cross-funcionales y full-stack):
- Primero se hacía un test end-to-end de la invocación de un caso de uso pero desde la capa HTTP. Estos tests son similares a los tests de aceptación de ATDD. Este test iba a estar fallando hasta que se implementaran todas las funcionalidades. Para estos tests usamos RestAssured que nos permitía fácilmente ejecutar y analizar requests HTTP. Para armar el escenario ejecutamos comandos reales del core de la aplicación. Este test a medida que lo ejecutáramos y fuera fallando nos iba a ir indicando lo próximo a implementar.
- Hacíamos TDD con tests sociables sobre los casos de uso (comandos, queries o event handlers). Si utilizaban algo de la infraestructura usábamos test doubles (por ejemplo una implementación del repositorio in-memory). En general el dominio se testeaba desde aquí indirectamente; los principales conceptos iban apareciendo mediante el paso de refactoring.
- En algunos casos más complejos hacíamos directamente TDD sobre objetos de dominio para descubrirlos y testear comportamientos que es muy difícil ver desde afuera.
- Finalmente, hacíamos tests de integración sobre los objetos de infraestructura. Por ejemplo testeábamos un repositorio real de jOOQ usando una base de datos real. Solíamos usar transacciones para deshacer los cambios que hizo el test.
Ejemplo de test end-to-end:
  @Test
  fun createField() {
    val request = CreateField.Request(aFieldName, someHectares, aPlanId, sessionToken)
    every { mediator.command<CreateField>().execute(request) } returns aFieldId

    Given {
      contentType("application/json")
      header("Authorization", "Bearer ${sessionToken}")
      jsonBody(
        JsonObject()
          .add("name", aFieldName)
          .add("hectares", someHectares.toInt())
          .add("planId", aPlanId.toInt())
      )
    } When {
        post(baseUrl() + "fields/create")
    } Then {
        isSuccessful()
        isJson()
        body("fieldId", equalTo(aFieldId.toInt()))
    }
  }
Ejemplo de test de un caso de uso:
  @Test
  fun `create each task with 'pending' status`() {
    val plan = scenario.plan { ownedBy(user) }
    scenario.field { plan(plan); program(scenario.simpleProgram()) }

    startProduction.execute(plan.id, sessionToken)

    with(generatedTask()) { assertThat(status).isEqualTo(TaskStatuses.Pending) }
  }
Ejemplo de un test de dominio:
  @Test
  fun `harvestCost is the sum of the labor cost of all harvest tasks`() {
    val task1 = scenario.task { harvest() }
    val task2 = scenario.task()
    val task3 = scenario.task { harvest() }

    val financials = PlanFinancials(tasksFinancials(task1, task2, task3), someFieldsFinancials)

    assertThat(financials.harvestCost()).isEqualTo(task1.laborCost() + task3.laborCost())
  }
Para la creación de escenarios en los tests de casos de uso y del dominio utilizamos test data builders y test examples.
object GrainExamples {
  val grainNames = TestExamples("Maíz", "Trigo", "Cebada", "Arveja")

  fun aGrainId() = GrainId(85)
  fun otherGrainId() = GrainId(77)
}
Para el control del tiempo en los tests modelamos una abstracción de reloj (Clock) donde en los tests usamos un StoppedClock que nos permitía controlar explícitamente el reloj. En el código productivo usamos un SystemClock.
Metodología de trabajo
Trabajé con equipos cross-funcionales que tenían todos los roles necesarios para construir un producto: Product Owner, diseño gráfico y developers full-stack. Los programadores eran generalistas-especialistas: si bien algunos tenían mayor conocimiento en mobile, web, backend o infraestructura, todos podían colaborar en cualquier parte del código y manejaban todos los temas. El Product Owner además hacía QA exploratorio.
Trabajábamos diariamente con pair y mob programming. Esto hacía que el conocimiento fluyera y que rápidamente todos aprendieran todo.
Hacíamos TDD e integración continua, no usábamos feature branches en Git, hacíamos micro-commits como parte del flujo de TDD y estos se integraban en GitLab con un pipeline que revisaba que estuviera todo bien.
Cuando algo fallaba en la única rama que teníamos (main) era prioridad del equipo entero solucionarlo. Main siempre estaba listo para ser desplegado. Cada commit que pasaba el pipeline se desplegaba automáticamente al entorno de staging y se les notificaba a los stakeholders para que pudieran ver diariamente lo último y darle feedback al equipo.
Para mobile usábamos Firebase App Distribution para que cada uno pudiera tener en su celular siempre la última versión.
El deploy a producción se hacía integrando el código a una rama especial llamada "production". Este proceso estaba 100% automatizado.
Como hacíamos integración continua, micro-commits y TDD, el refactor del código era cotidiano, sucedía con cada ciclo de TDD. Esto ayudaba a que el código no acumulara deuda técnica y fuera evolucionando a medida que íbamos aprendiendo más sobre el negocio.
No usábamos Scrum: teníamos un tablero Kanban con indicadores que nos indicaban cuándo debíamos juntarnos a planificar otro lote de historias de usuario para agregar (planificación on-demand).
En cada columna del tablero teníamos un límite de WIP para evitar que las tarjetas se acumularan y detectar de forma temprana cuellos de botella. El flujo estaba optimizado para minimizar el lead-time y maximizar el throughput.
No estimábamos. Sliceábamos las historias de usuario para que su tamaño fuera aproximadamente de 1 o 2 días. Para hacer pronósticos contabilizábamos el throughput semanal (contando la cantidad de historias que pasaron a done en esa semana) y proyectábamos en base a eso.
Casi no hacíamos dailies, puesto que hablábamos y trabajábamos en equipo todos los días. Cada 2 semanas nos juntábamos a hacer una retrospectiva para optimizar el proceso y detectar problemas.
Para la gestión del backlog usábamos user story mapping.